

市販の映像生成
- 1152×672 の静止画 1 枚、エンドツーエンド
- ≈26s
- 音声付き 5.17 秒の動画 1 本、エンドツーエンド
- 57–76s
- 1 回のレンダリングに 2 台・3 GPU
- 2 · 3
- 1 枚の RTX 5080 で完走した H3 DiT エンジン
- 37/40
2026-10-18 に実測。静止画は t2i レンダリング 4 回(25.8〜26.9 秒)で、テキストエンコーダー・DiT・VAE を RTX 5080、合成を CPU で実行しました。動画は fl2va レンダリング 4 回で、テキストエンコードを DGX Spark(GB10)、DiT と映像デコードを RTX 5080、音声を RTX 3060 で実行しています。
ひとりのキャラクター、13の実際の出力。
オリジナルキャラクター The Courier の設定画から、静止画、音付きの動画クリップまで、すべて Phasyn Studio で 2 台のマシンを使って生成しました。レンダリング時間は合計で約 11 分です。
AI 生成コンテンツを含みます(MiniMax H3・Qwen-Image 2.1)
4 枚の静止画から、音付きの動画を 4 本。
 AI 生成 · Powered by MiniMax H3
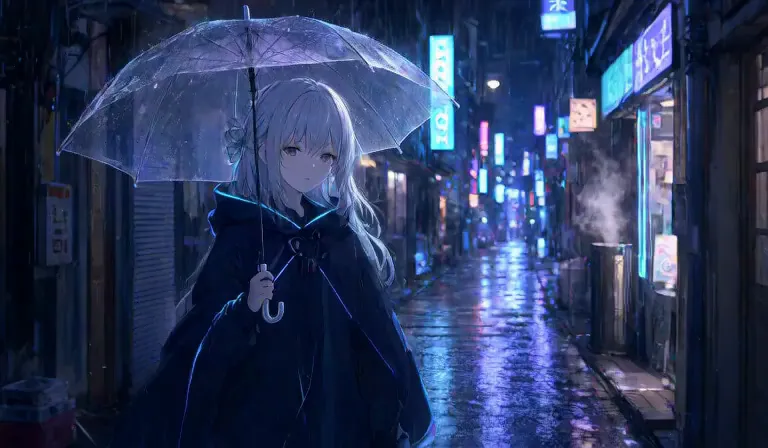
雨の夜の路地fl2va · seed 202 · エンドツーエンド 57.2 秒テキスト GB10 · DiT と映像 RTX 5080 · 音声 RTX 3060 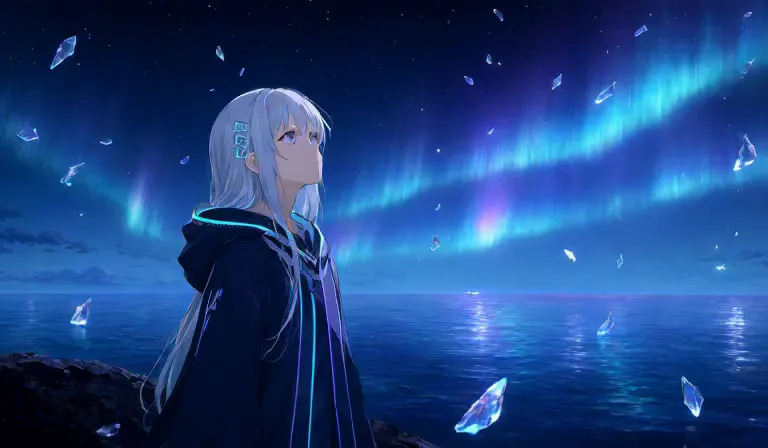 AI 生成 · Powered by MiniMax H3
オーロラの海fl2va · seed 303 · エンドツーエンド 57.4 秒テキスト GB10 · DiT と映像 RTX 5080 · 音声 RTX 3060 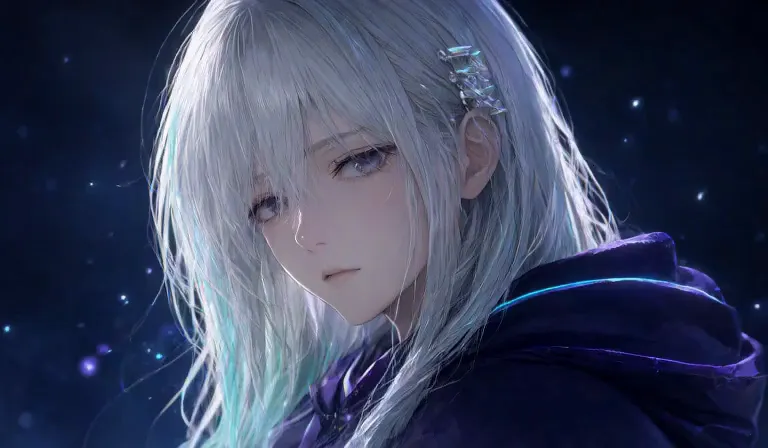 AI 生成 · Powered by MiniMax H3
光の粒の中で目覚めるfl2va · seed 404 · エンドツーエンド 58.6 秒テキスト GB10 · DiT と映像 RTX 5080 · 音声 RTX 3060 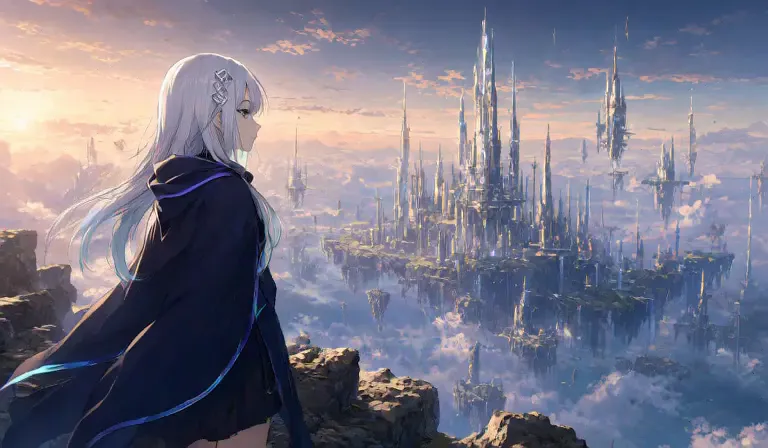 AI 生成 · Powered by MiniMax H3
夜明けの崖fl2va · seed 101 · エンドツーエンド 76 秒テキスト GB10 · DiT と映像 RTX 5080 · 音声 RTX 3060
時間はコントローラーが記録したエンドツーエンドの値で、モデルの起動(切り替えごとに 11〜46 秒)は含みません。動画の出力解像度は 768×448 です。Web 版はラウドネスの正規化のみ行っています(元の出力は約 −37〜−50 LUFS、AAC 32 kHz)。
作例をすべて見るなぜ自分で作ったのか
- 市販の映像生成
サービスは、 質が悪くて高いうえに、 クレジット制です。 - ComfyUI
のようなローカル ツールは、 実際の 操作性も 高速化も考えていません。
テキストも、画像も、動画も、ひとつの流れで。
ひとつのプロンプトから、音付きの動画まで。どのステップも見えて、どのステップも調整できます。
- 01テキスト
ひとことから、始めます。
プロンプトを書きます。Image Studio はそこから画を生成し、Video Studio では @Image1・@Video1・@Audio1 で参照素材を指定できます。スニペット、ブロック表示、整形ツールもすぐ手元にあります。
- プロンプト
- @ 参照素材
- スニペット
- 02画像
まず、絵を決めます。
Image Studio で Qwen‑Image 2.1 を使って画像を生成します。生成のたびに take が残り、並べて比べてから、動画ショットの先頭フレームにする 1 枚を選べます。
- テキストから画像
- 画像から画像
- マスク編集
- 03動画
動かします。音も一緒に。
テキスト、画像、動画、音声を参照にできます。MiniMax H3 が、映像と同期した音声を同時に生成します。
- t2va · テキスト
- fl2va · 先頭フレーム
- ref2va · 参照素材
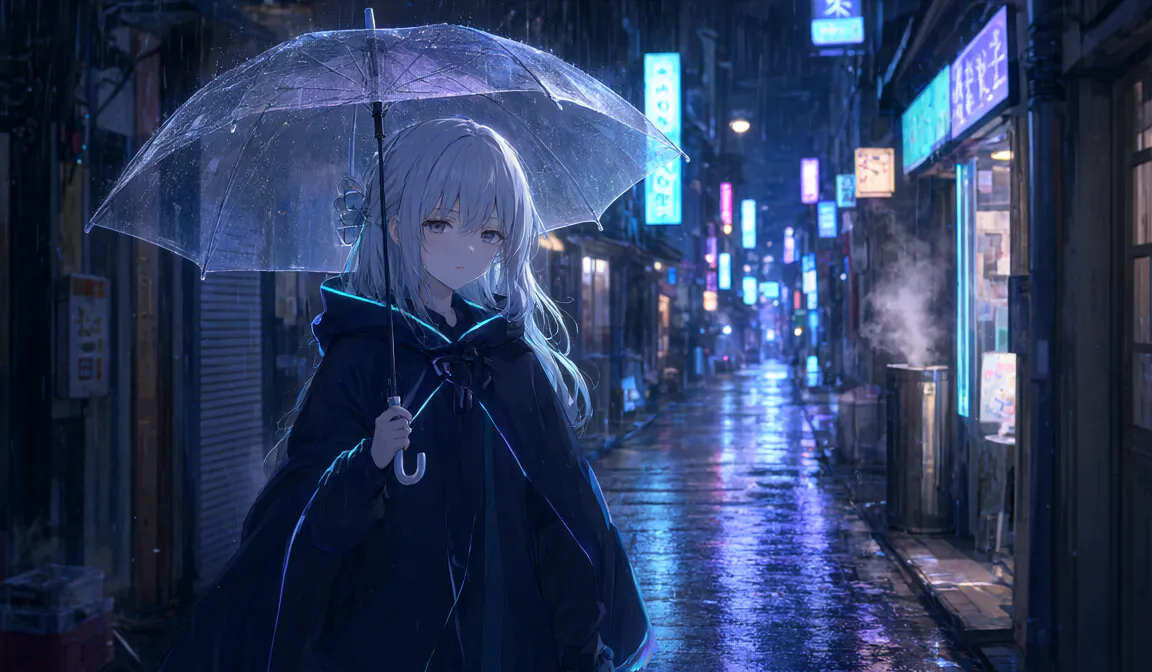 AI 生成 · Powered by MiniMax H3実際の出力
 先頭フレームH3 fl2va768×448 · 5.17 s · cfa759dfAI 生成 · Qwen-Image 2.1
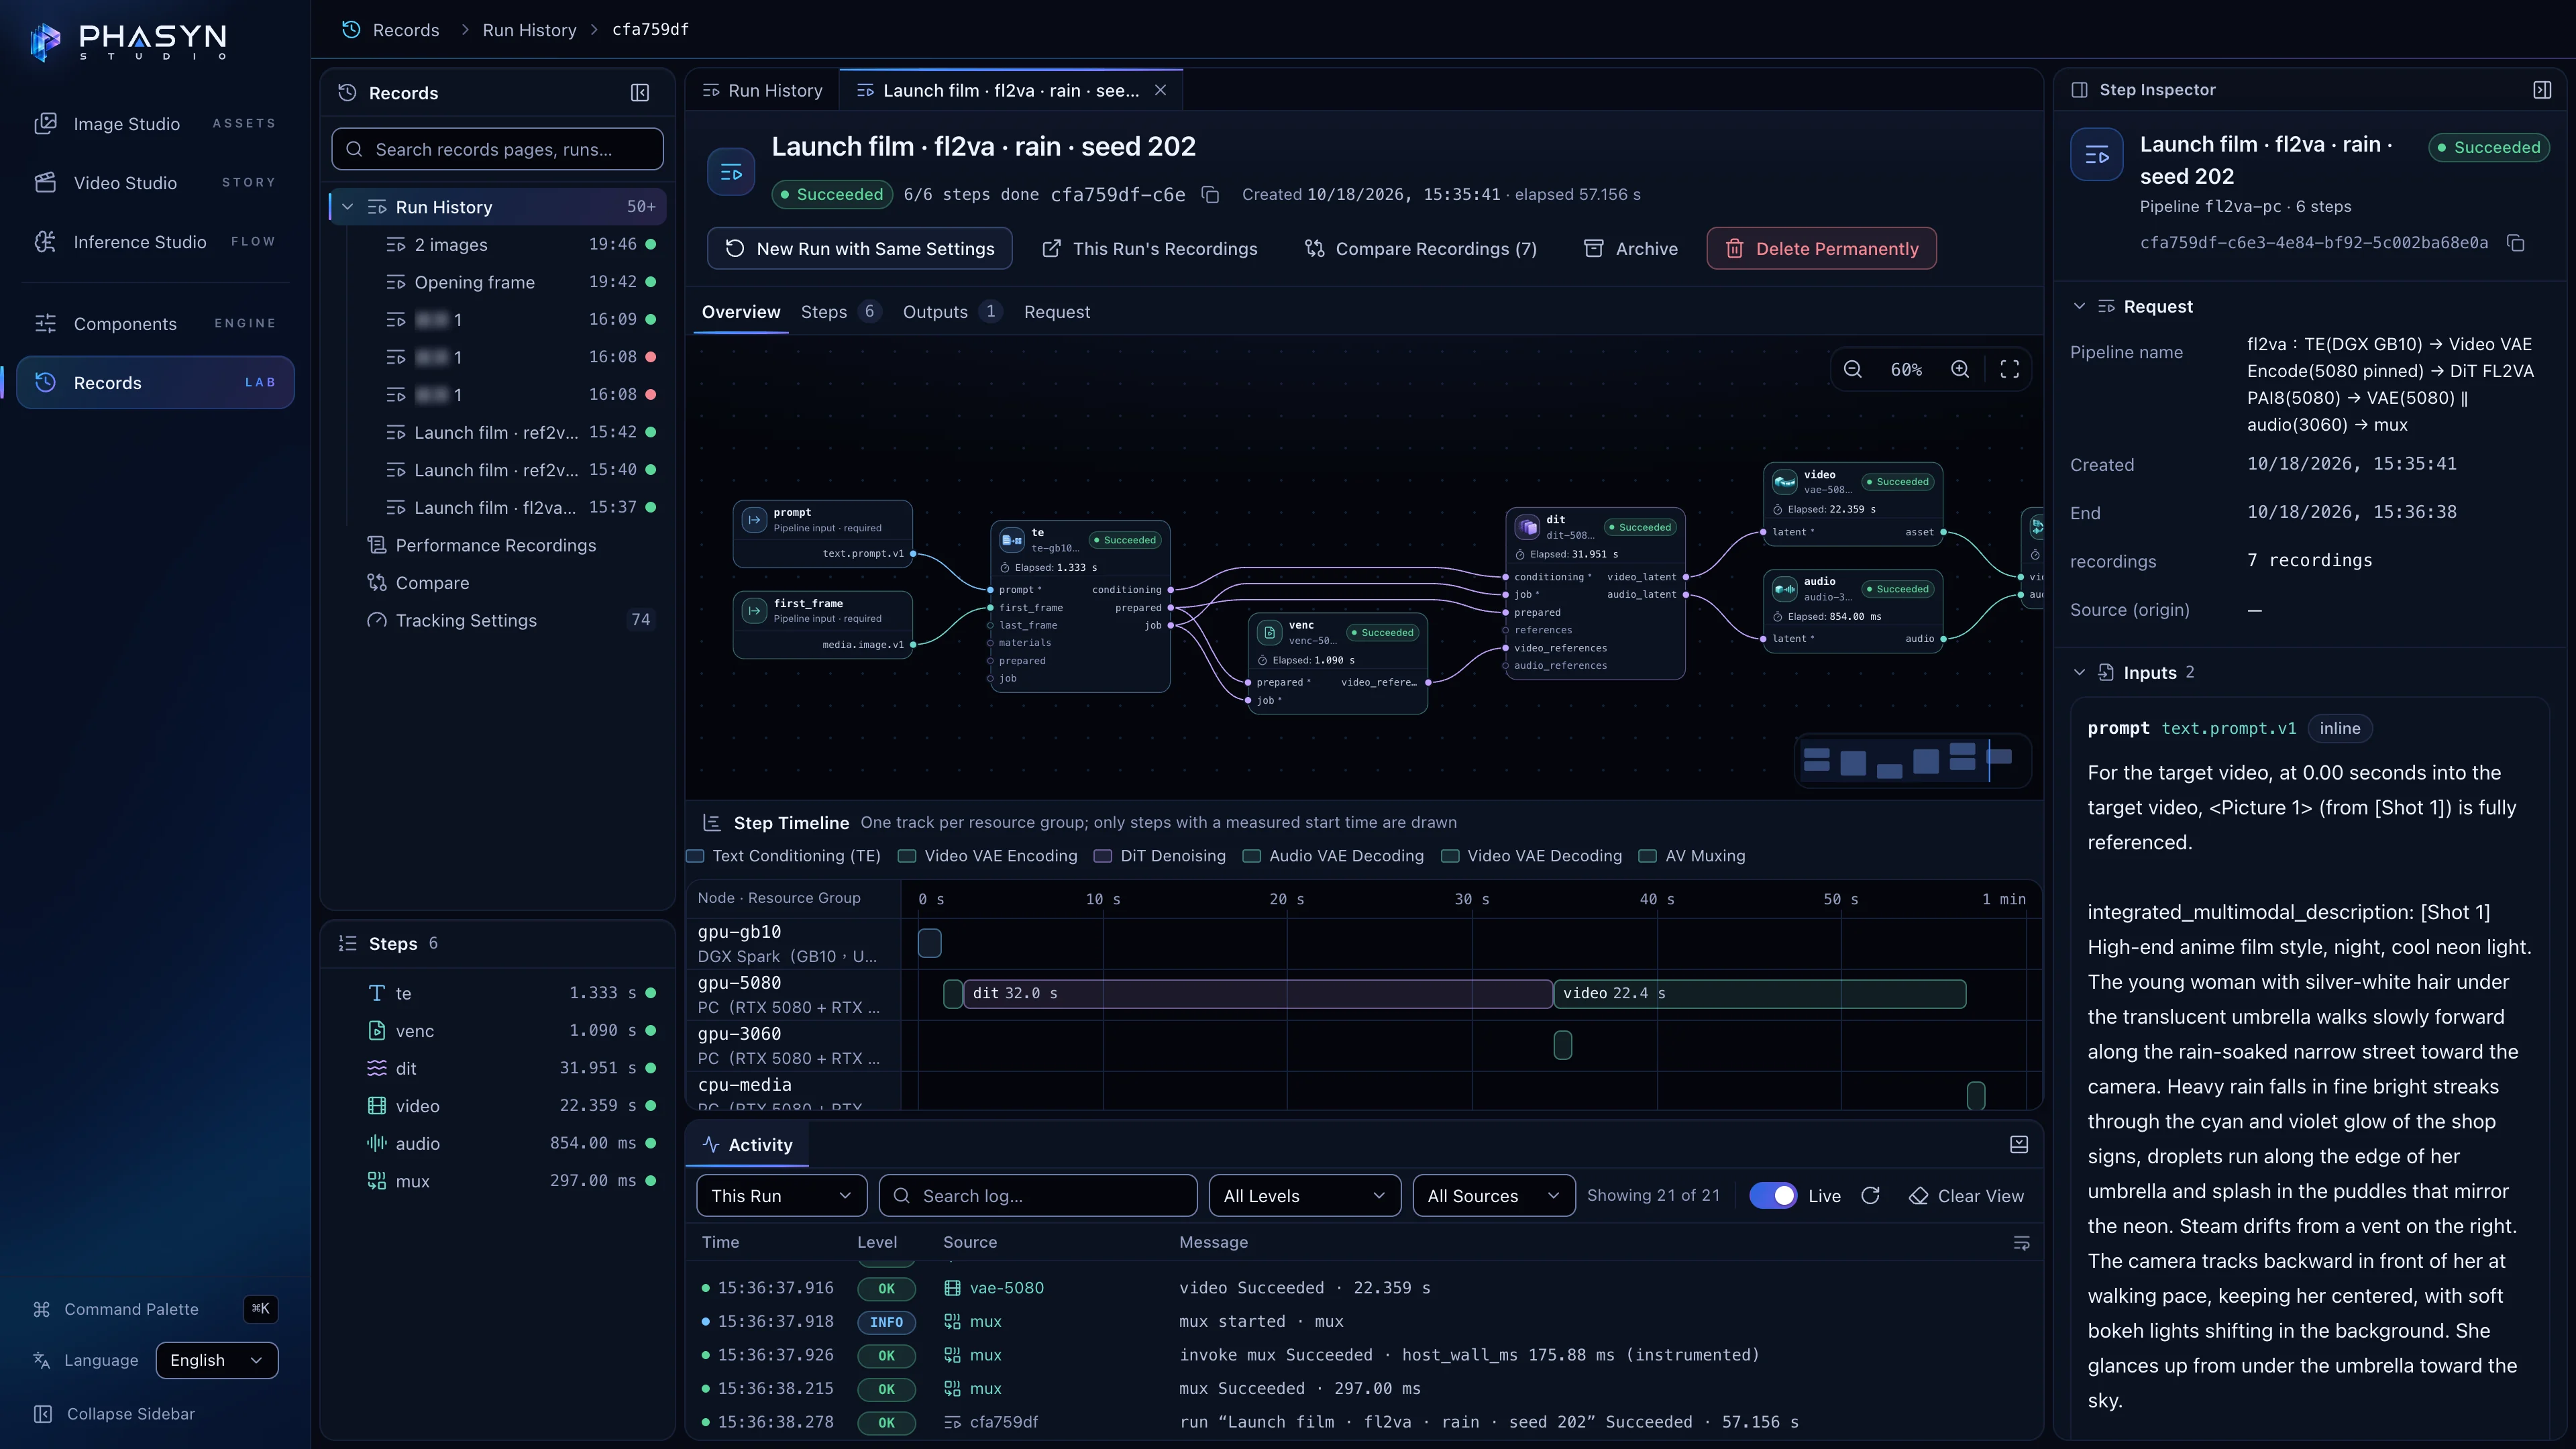
実際の出力です。この Qwen‑Image 2.1 の静止画を先頭フレームにして、H3 fl2va が音声付きの動画を生成しました(run cfa759df)。Web 版はラウドネスを正規化しています(元の出力は約 −37〜−50 LUFS、AAC 32 kHz)。
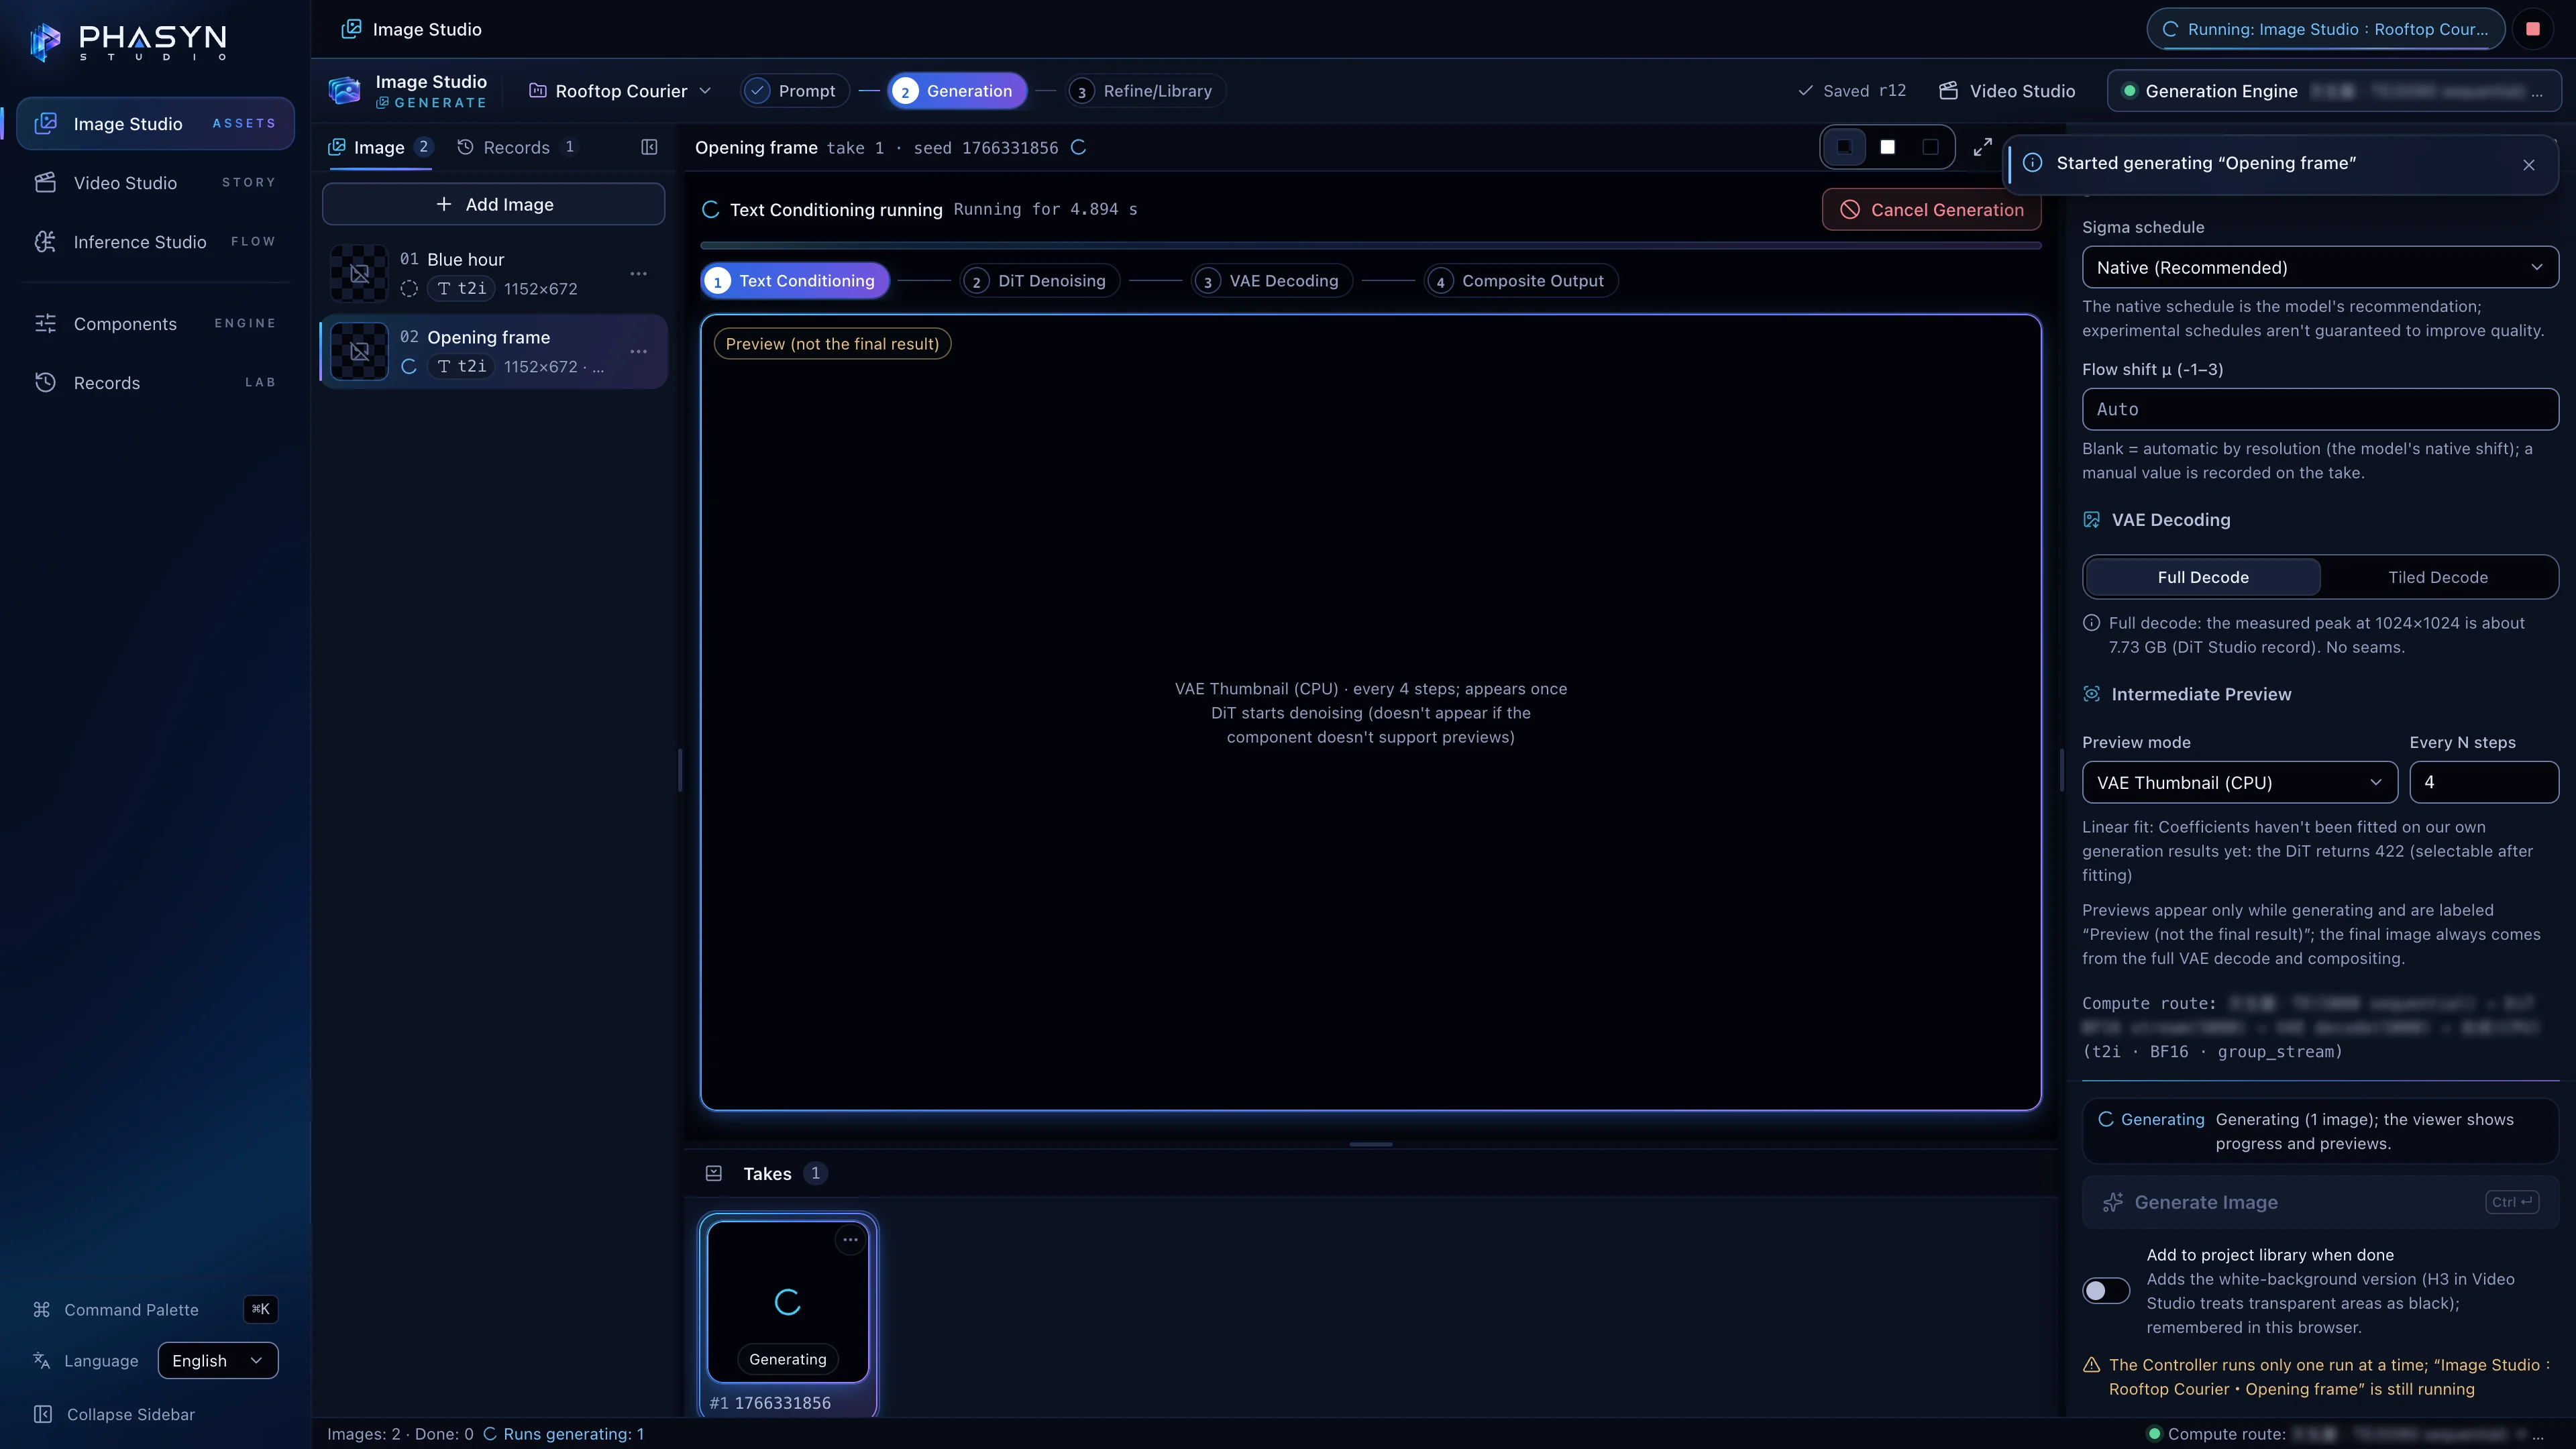
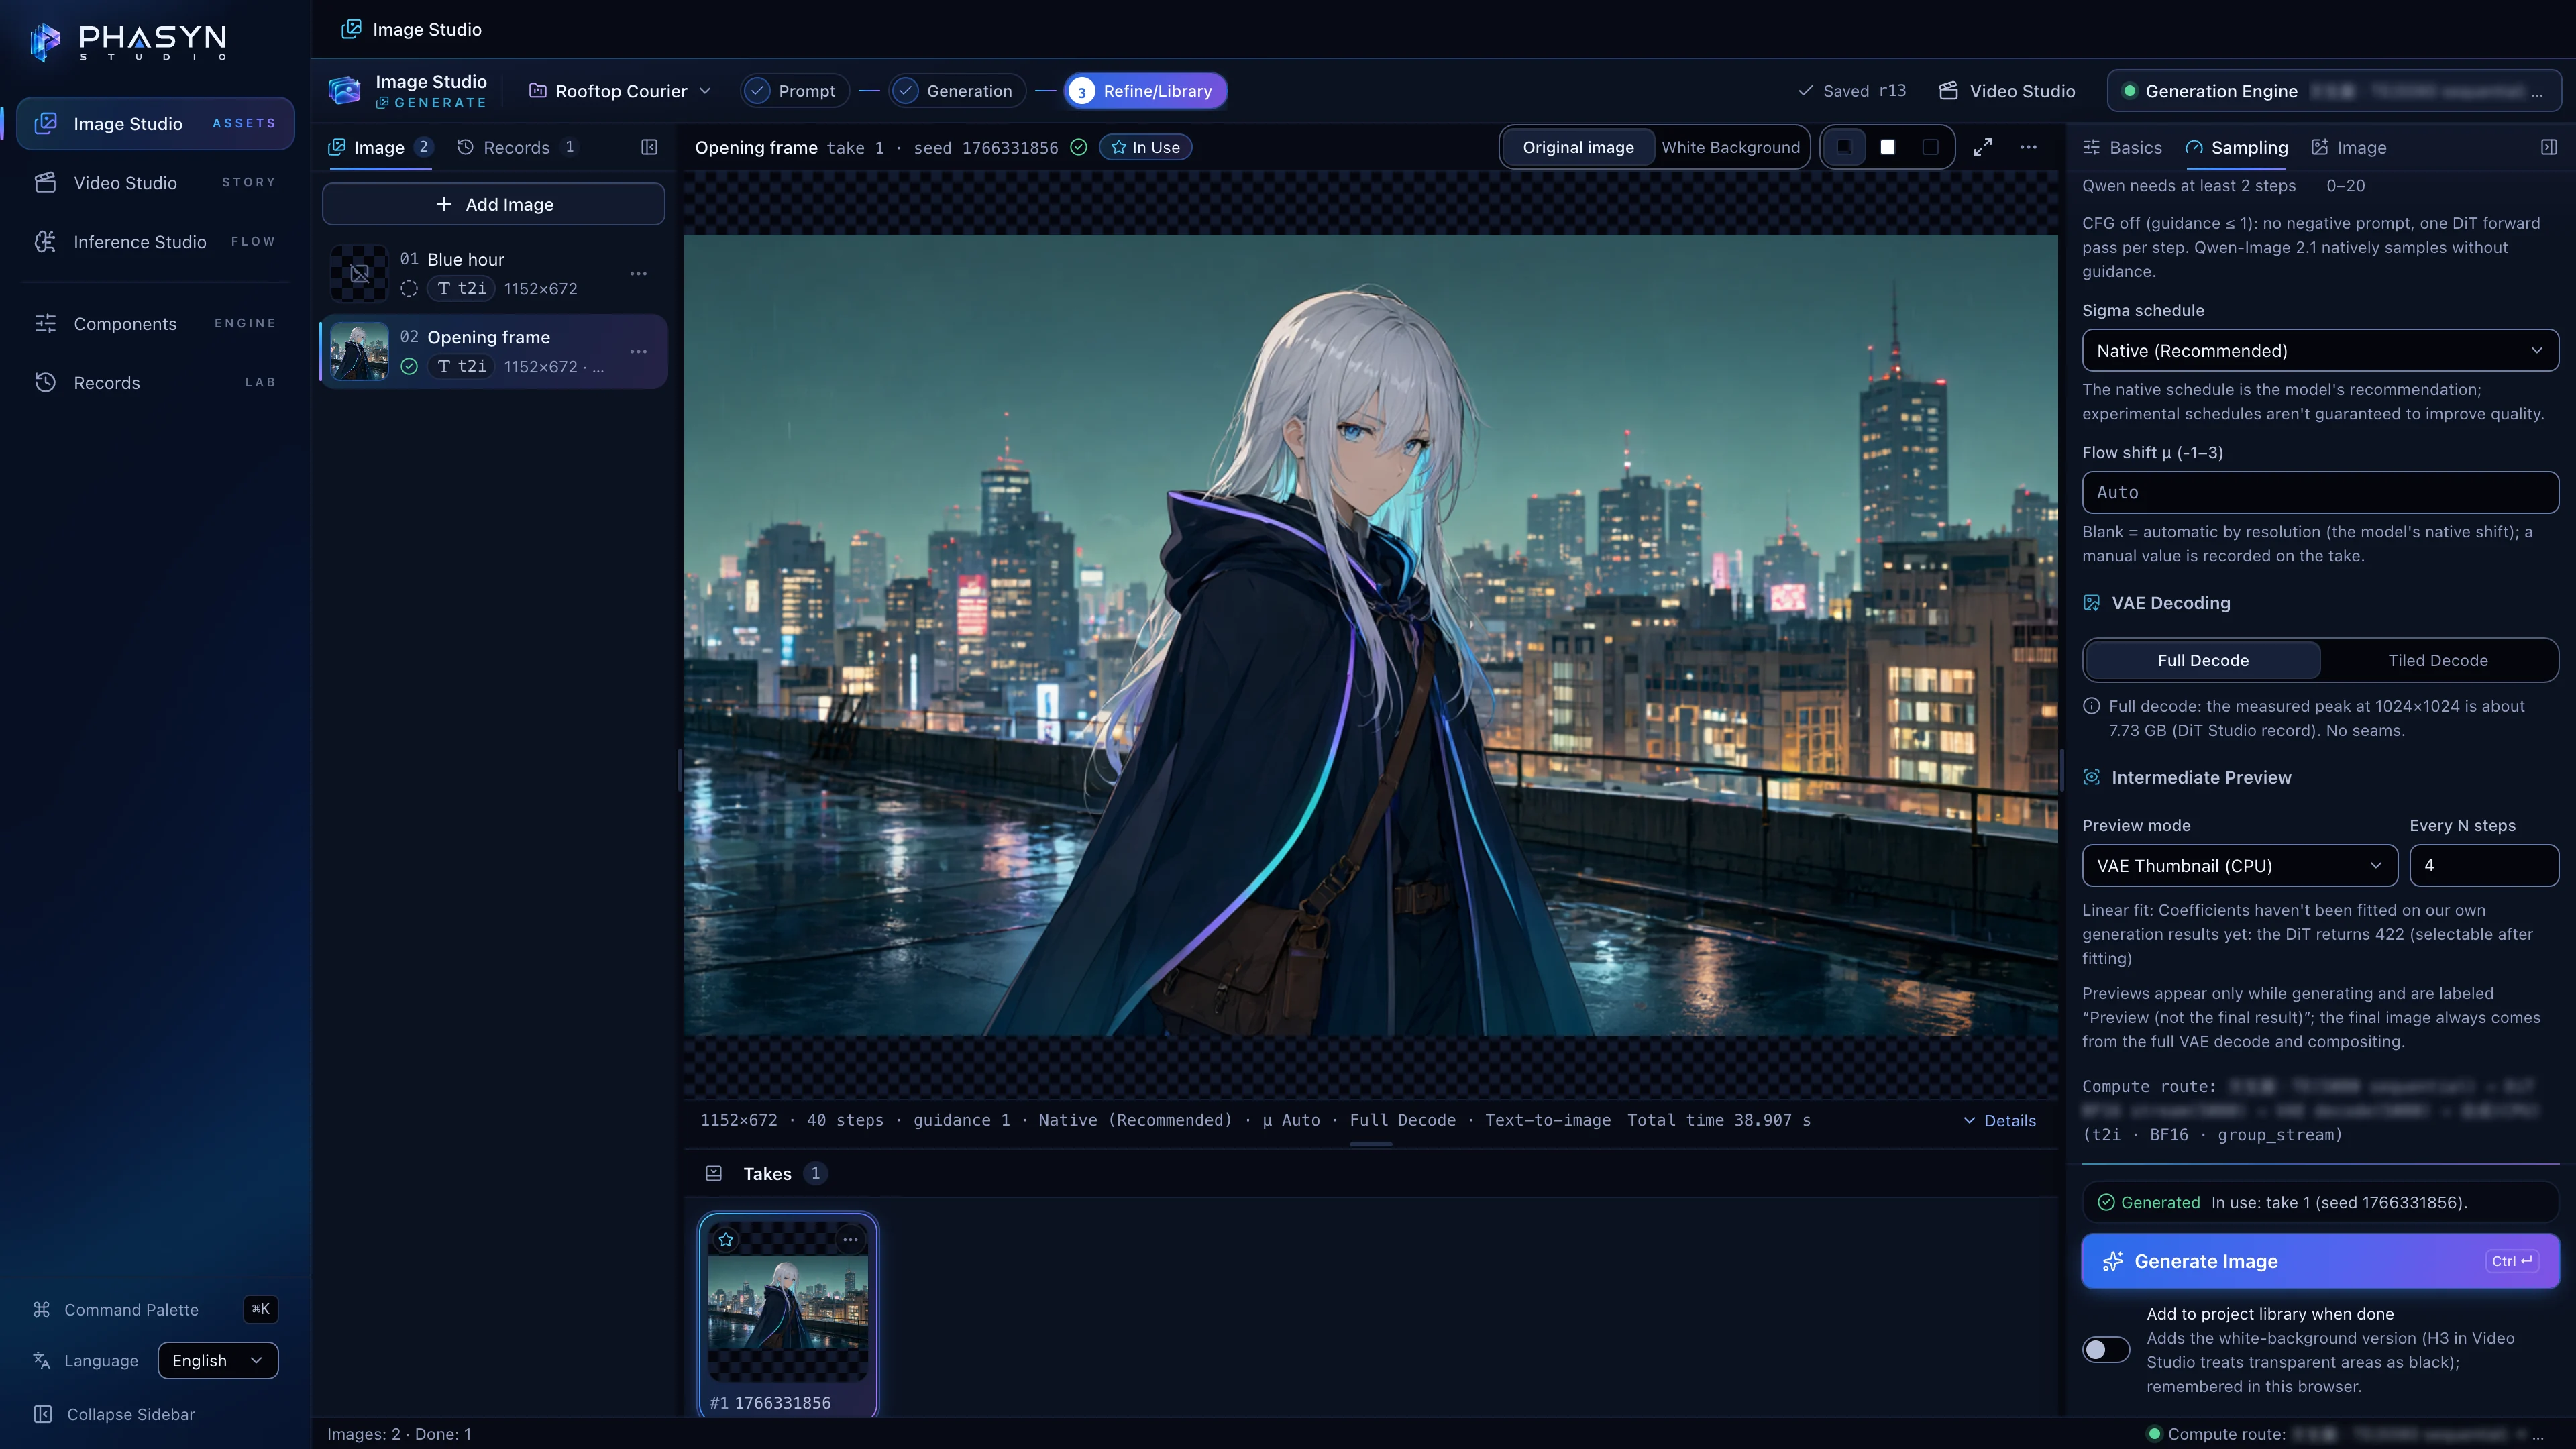
UI は Phasyn Studio の実際の画面(英語 UI)です。静止画と動画は実際の出力です。静止画は Image Studio と同じ t2i‑pc パイプラインの Qwen‑Image 2.1 で生成しました(1152×672、エンドツーエンド約 27 秒:テキストエンコーダー・DiT・VAE は RTX 5080、合成は CPU)。動画はこの画像を先頭フレームにして H3 fl2va で生成しました(768×448、24 fps、124 フレーム=5.17 秒、生成した音声付き)。下の Records の画面と同じ run cfa759df で、エンドツーエンド 57.2 秒でした(テキストエンコードは DGX Spark GB10、DiT と映像デコードは RTX 5080、音声デコードは RTX 3060)。
本気の制作のために。
どの機能も、実際に必要だったことから生まれました。
Prompt Advisor
74 のルールが、書いている途中のプロンプトを確認します(MiniMax 公式ガイド 45、インストール済みのコード 21、作成ガイド 8)。うち 21 件はワンクリックで修正でき、適用前に差分を確認できます。すべてのルールに出典があります。
@ 参照素材
@Image1・@Video1・@Audio1 で参照素材を指定すると、H3 のタグにそのまま対応します。
タイムライン・書き出し
分割、スナップ、ディゾルブ、速度変更、色調整、タイトル。最後は FFmpeg で MP4 に書き出します。
2026-10-18 に実測した出力:768×448、24 fps、124 フレーム(5.17 秒)、音声は AAC 32 kHz ステレオ。書き出し:MP4(H.264+AAC、完全に再エンコード。画質プリセットは CRF 18/23/28)。
画像からプロンプトへ
画像を渡すと、DGX Spark の視覚モデルがシーンの記述とプロンプト候補を書き起こします。
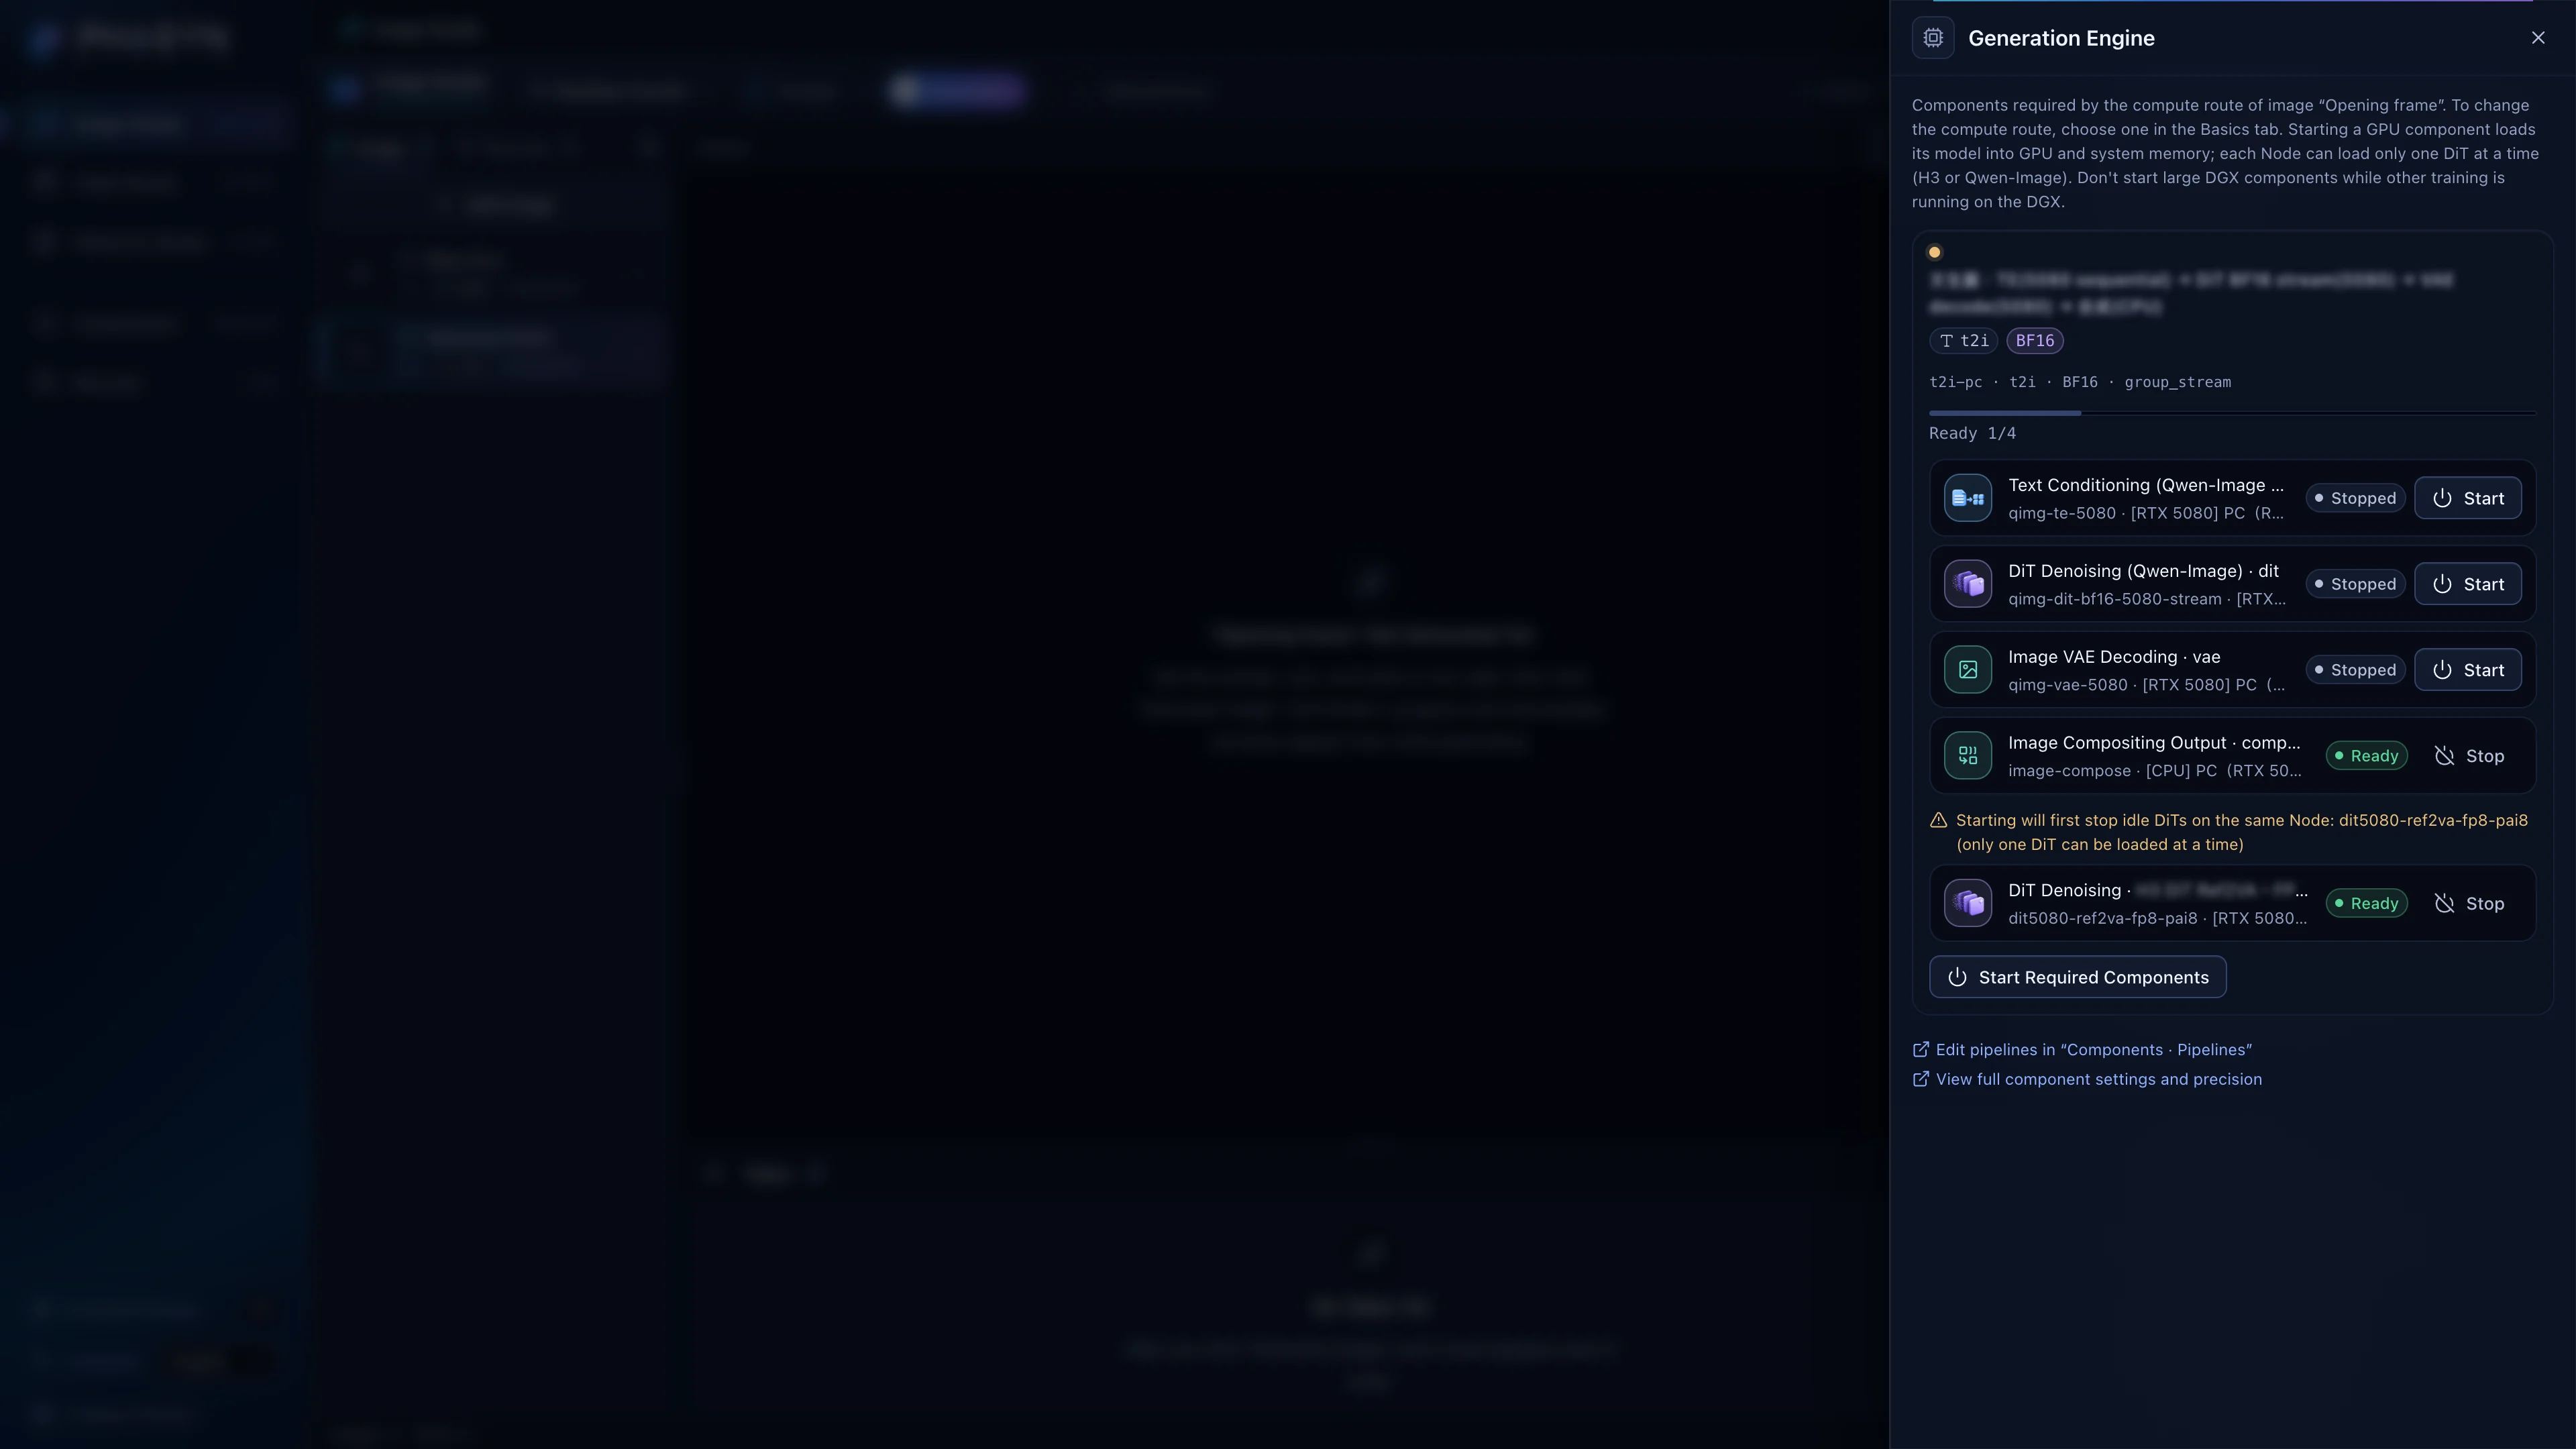
1 回のレンダリングを、2 台・3 GPU で。
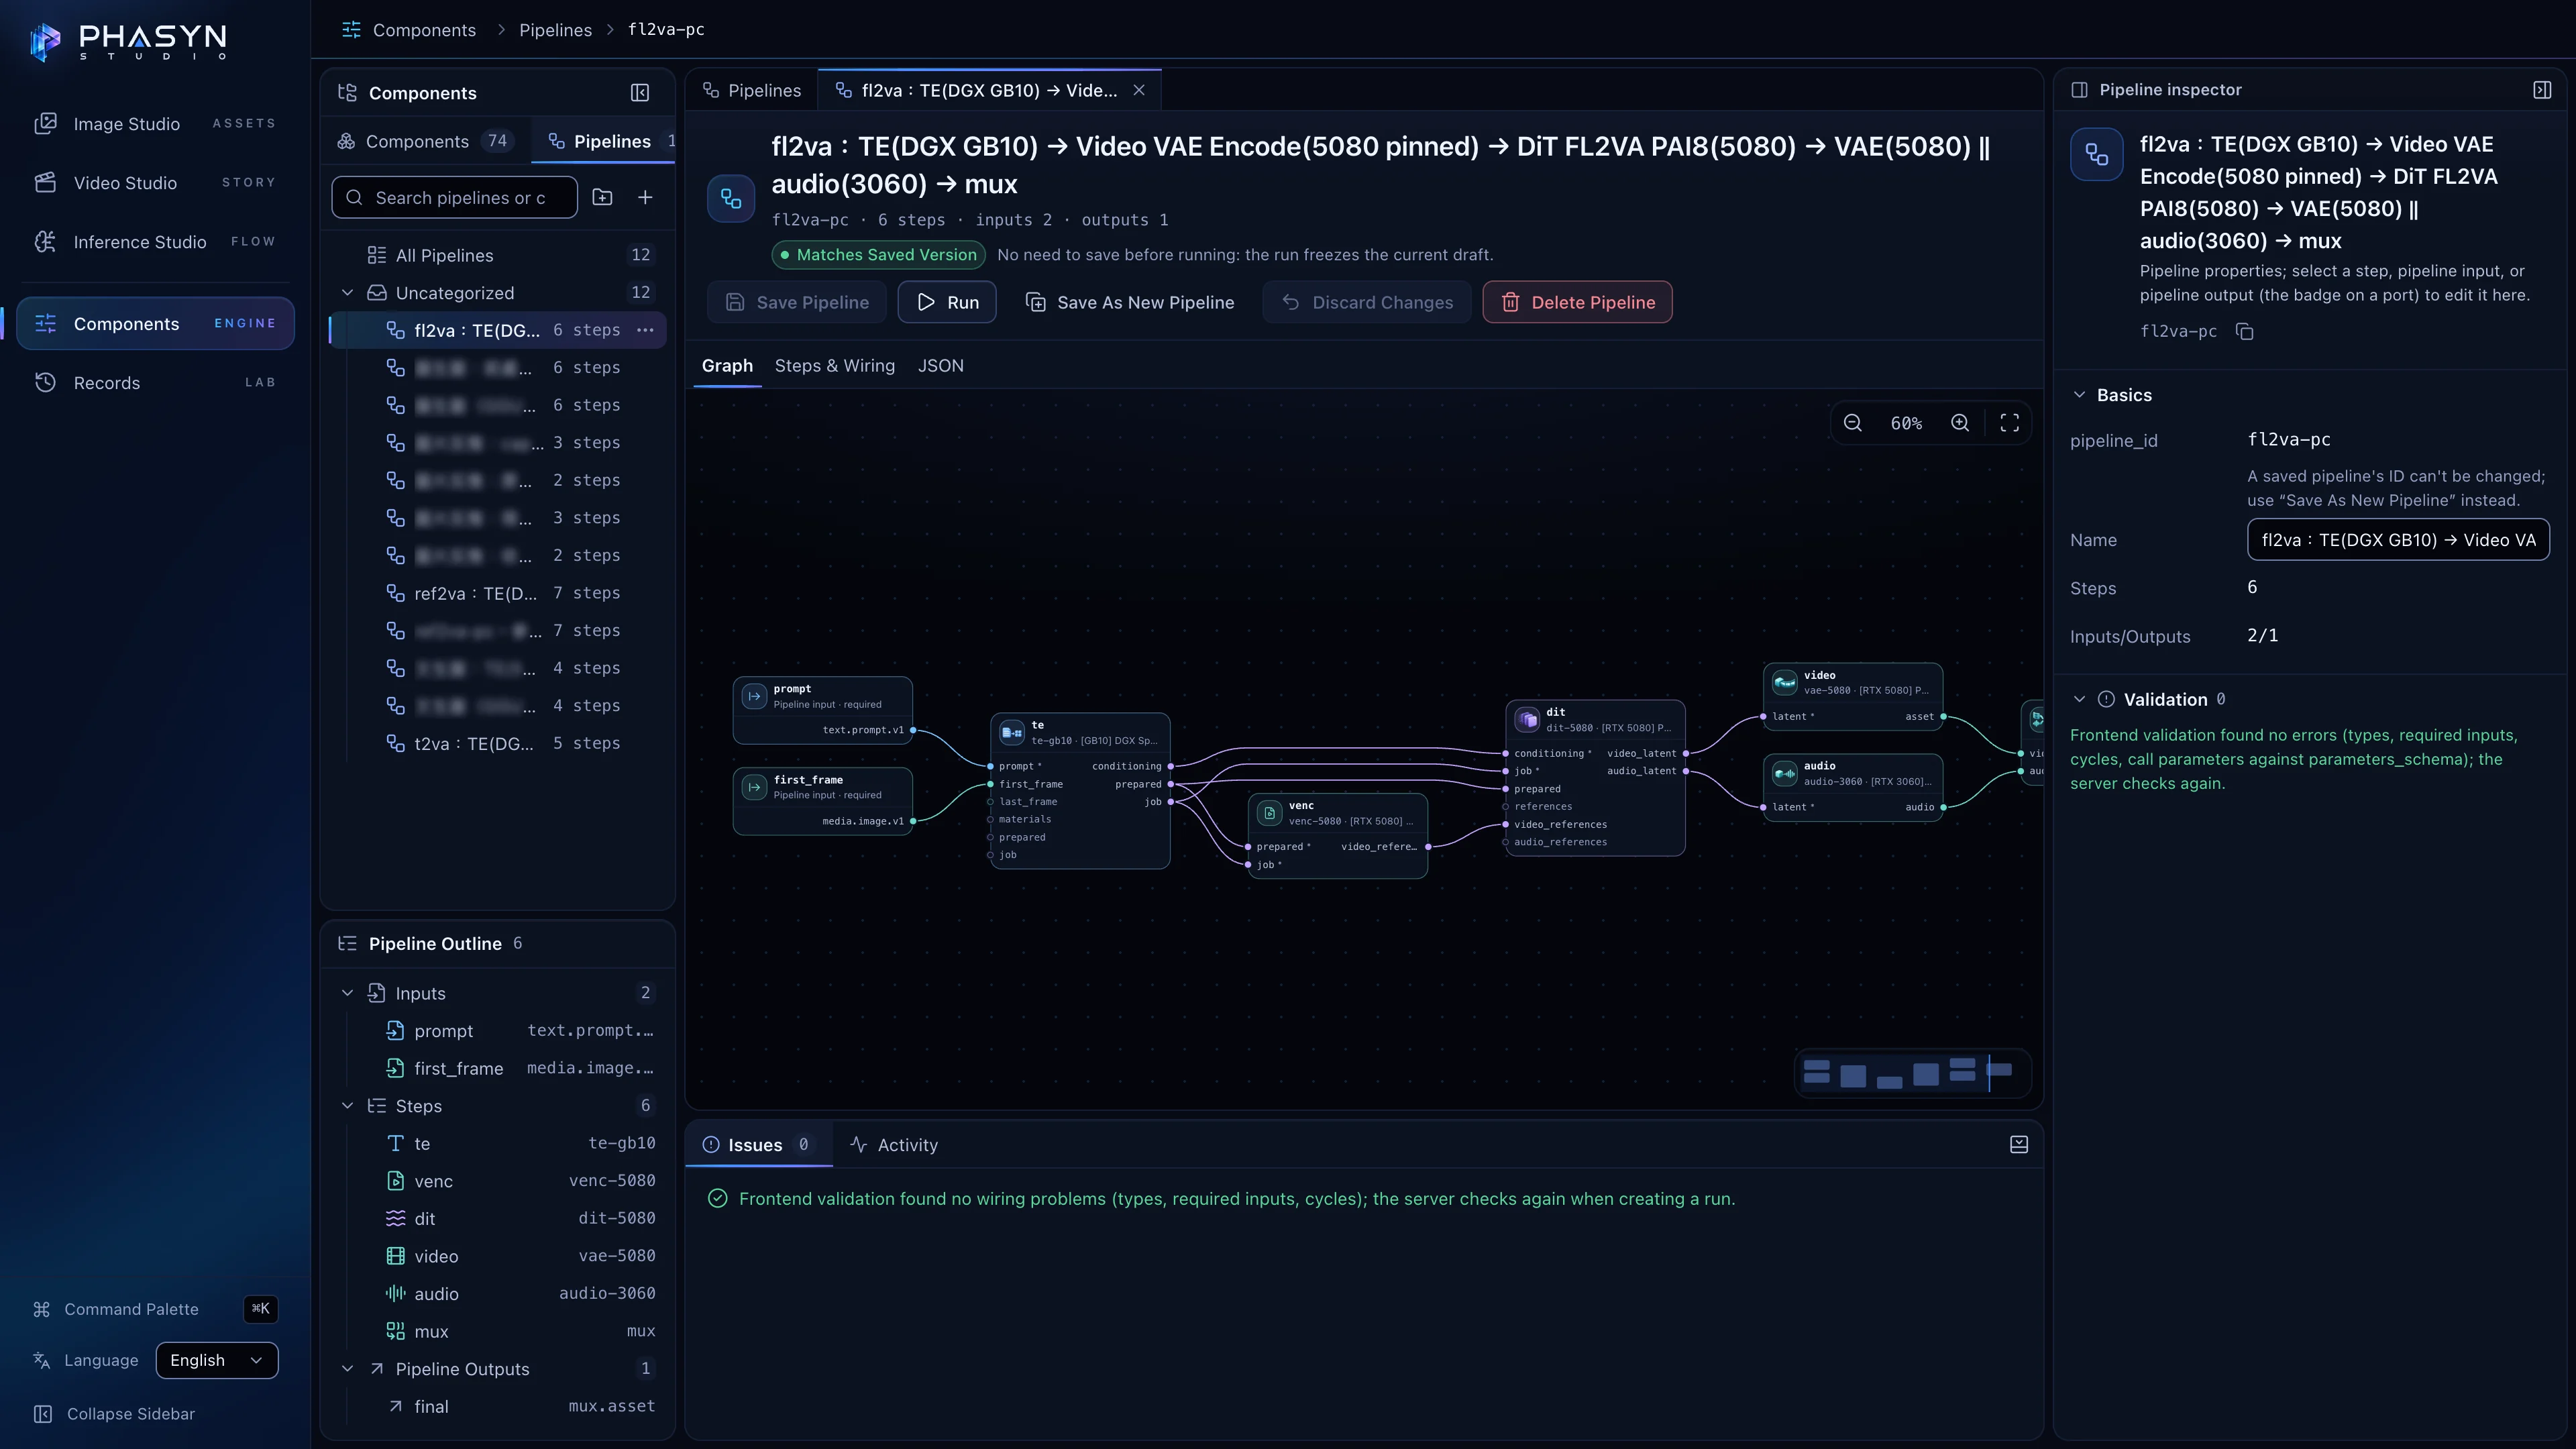
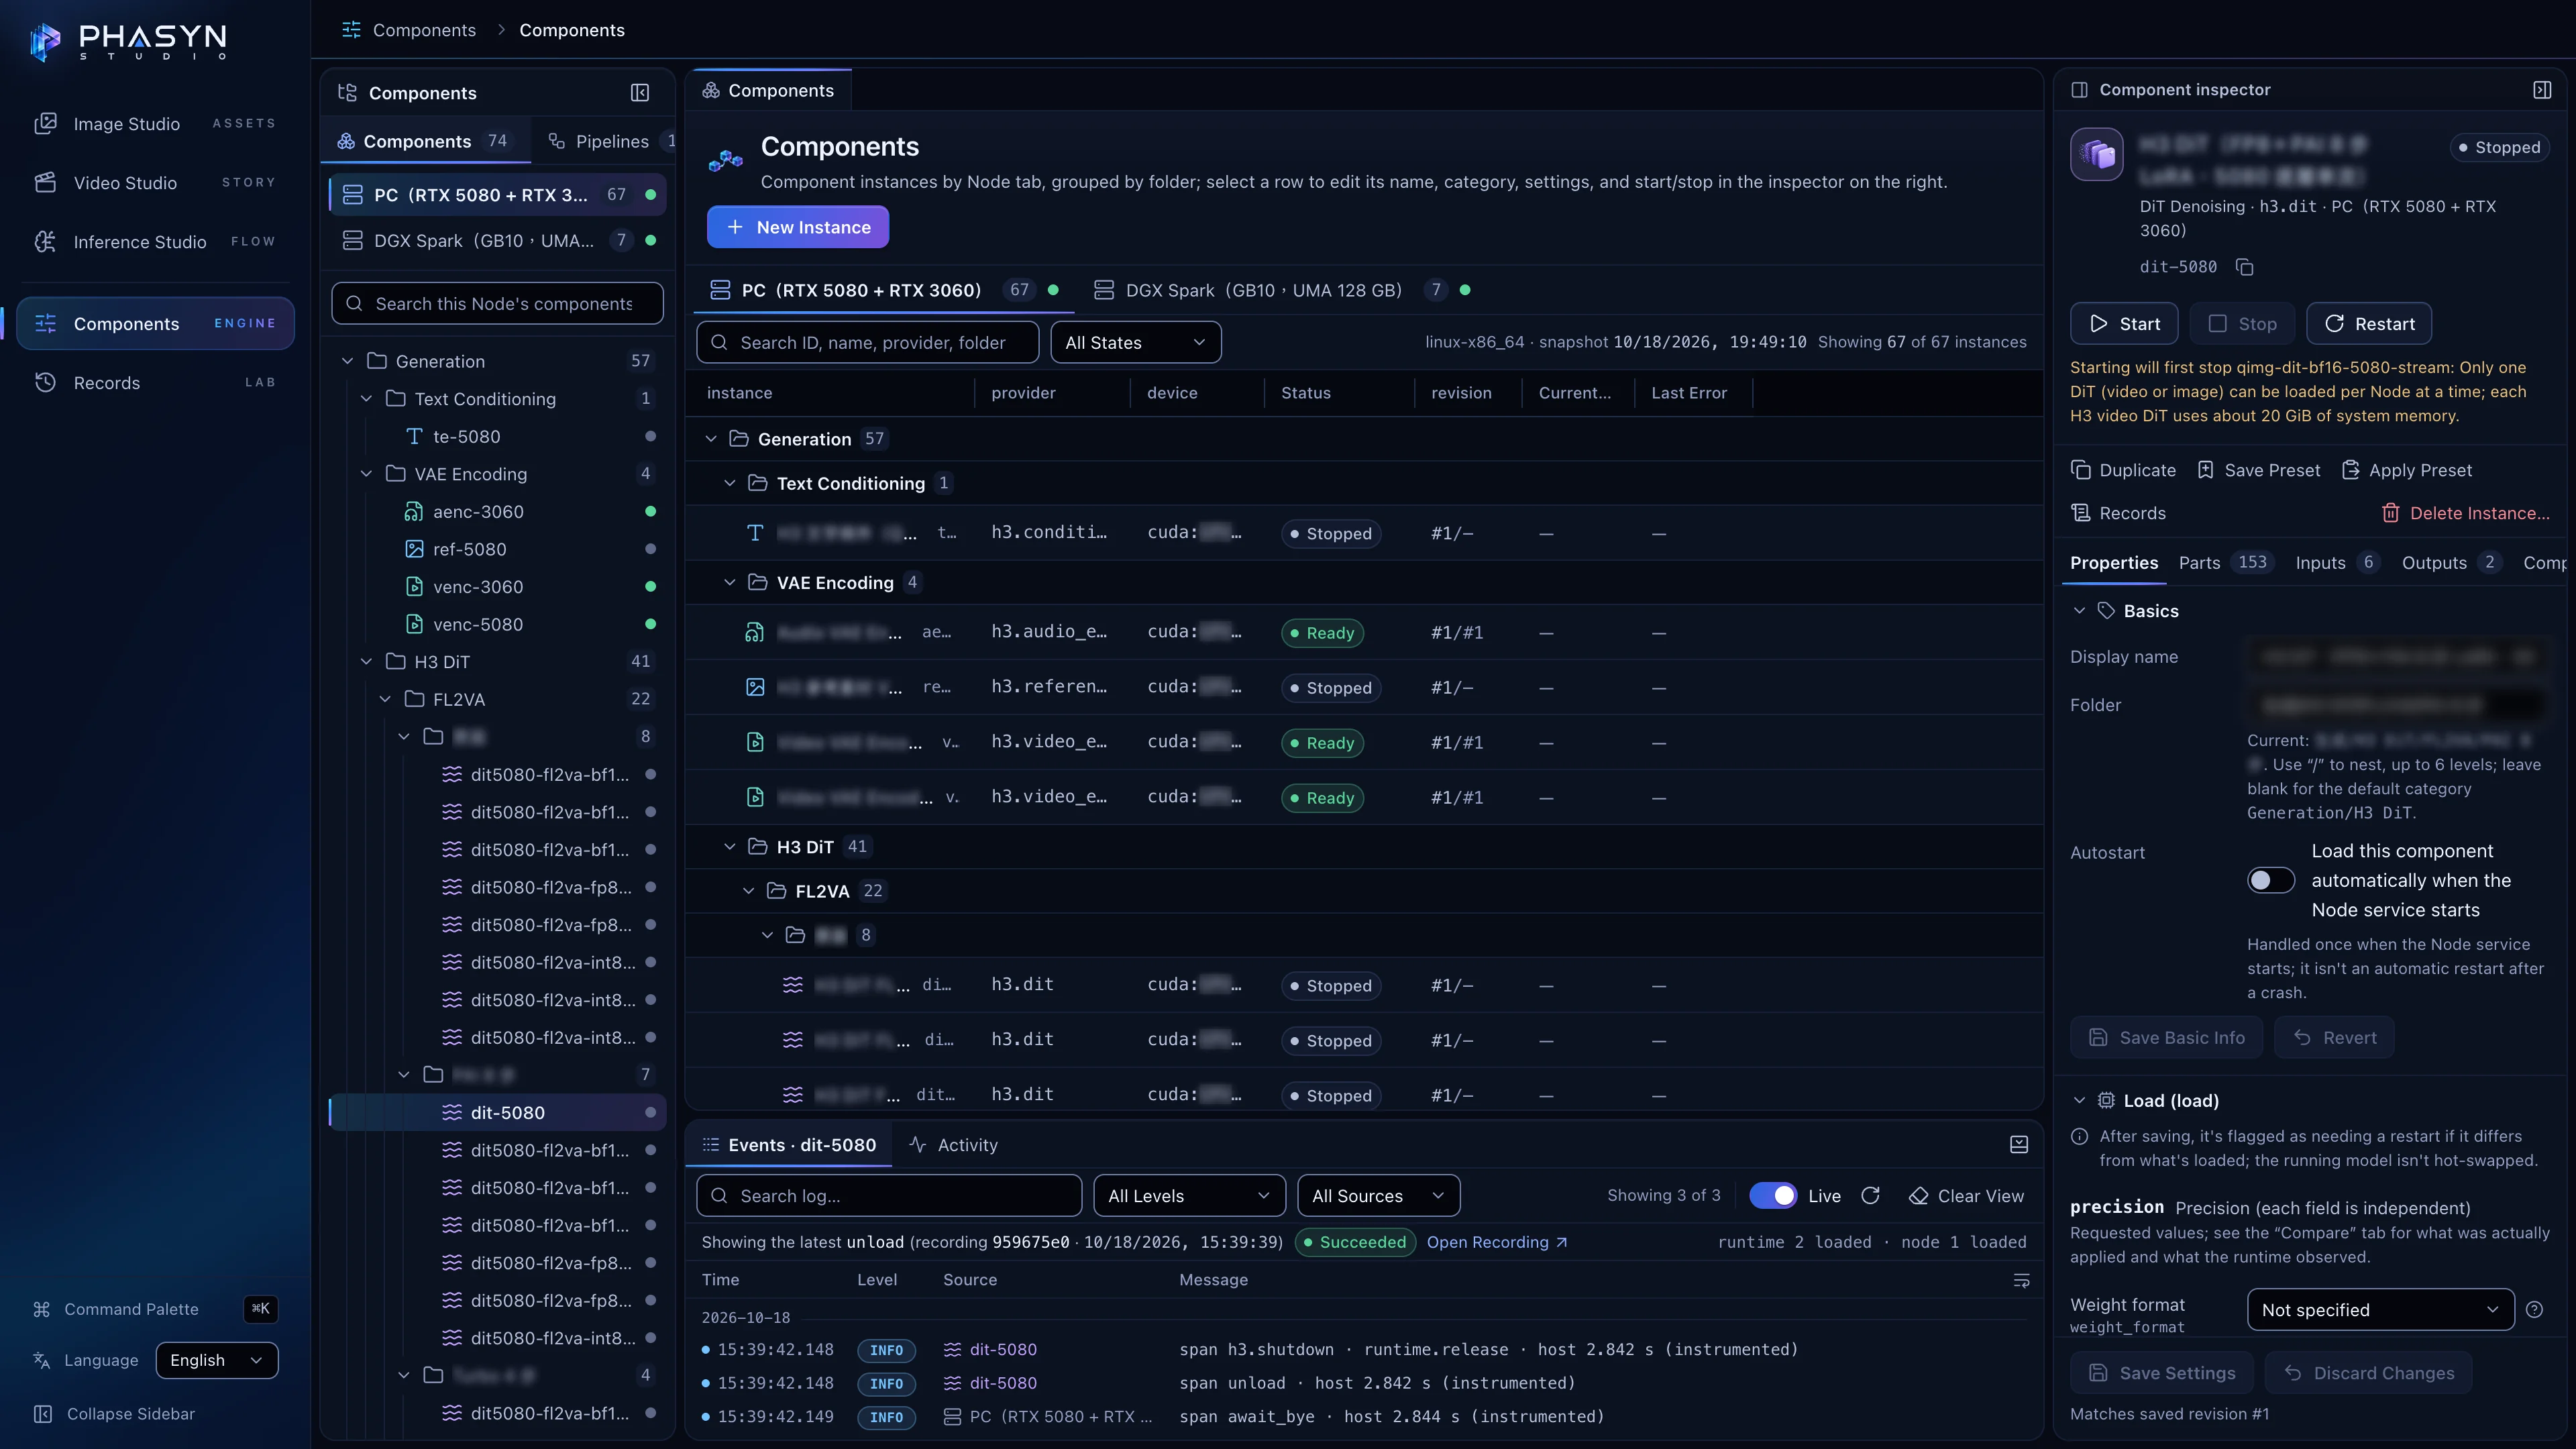
モデルのコンポーネントはそれぞれ独立したプロセスとして、選んだマシンで動きます。Recorder はすべてのステップの時間を記録し、計測していない値は「Not measured」と表示します。0 にはしません。
1 コンポーネント、1 プロセス
テキストエンコーダー、DiT、VAE、mux はそれぞれ別のプロセスで、精度とオフロードを個別に設定できます。ひとつのモデルが落ちても、アプリは止まりません。
ノードからノードへ
latent や映像などの大きな中間ファイルは FileRef としてマシン間を直接移動し、Controller を経由しません。Controller はスケジュールと記録、アップロードしたファイルの提供を担当します。実測では(2026-10-17 の t2va レンダリング)、PC 上の DiT が DGX Spark から 219〜322 KB の条件データを 30〜34 ms で受け取りました。
Recorder が定義する 102 の指標
どの指標にも単位と計測方法があります(CPU・GPU の時間、VRAM、転送量など)。fl2va レンダリング 1 回(run cfa759df)の 7 件の記録には、実際に 82 の指標が残りました。2〜8 件の記録を並べて比較し、JSONL・CSV・ZIP・trace で書き出せます。
エージェントにも。
付属の Agent Skill には、phasynctl コマンドラインツールと、必要に応じて使える MCP サーバー(22 ツール)が含まれています。
phasyn_doctor · phasyn_run_create · phasyn_runs_compare · phasyn_recordings_compare …
phasynctl runs create --dry-run は、何かをアップロードする前に、すべてのパラメーターを現在のスキーマと照合します。
phasynctl runs create / wait / download でスクリプトを書けば、まとめて送信し、完了を待ち、結果をダウンロードできます。Video Studio には Batch Render もあります。
実験 06 では、Studio の UI から 1 回、MCP から 1 回実行し、出力はビット単位で一致しました。
ほかのツールとの違い
- ノードベースのワークフローツールは、多くの場合グラフ全体をひとつのプロセスで実行します。Phasyn Studio はモデルのコンポーネント(テキストエンコーダー、DiT、VAE、mux)をそれぞれ独立したプロセスで動かすため、クラッシュが広がらず、1 回のレンダリングを複数のマシンにまたがらせることもできます。
- マルチバックエンドのフロントエンドは、ジョブ全体を別々のマシンに振り分けます。Phasyn Studio が分けるのは 1 回のレンダリングそのものです。テキストエンコードは DGX Spark、DiT は RTX 5080、音声は RTX 3060 で動きます。
- クラウドサービスは、現時点ではより高い解像度に対応しています。Phasyn Studio は自分のハードウェアで動き、クレジットは不要で、1 秒ごとの使い道を記録します。
現在の実行環境:RTX 50 シリーズ、RTX 30 シリーズ、DGX Spark(GB10)。RTX 40 シリーズ(4090 など)にはまだ対応していません。
複数のマシンを使うのは、1 回のレンダリングのコンポーネントを別々の GPU に分けるためです。現在は一度に 1 つの run を実行し、複数の映像を並列に処理するものではありません。
エンジニア向けの詳細:アーキテクチャ図と実際の画面
実測して、公開する。失敗も含めて。
H3 の DiT エンジン 40 種を 1 枚の RTX 5080 で計測しました。37 種が完走し、NF4 の 3 種は読み込めませんでした。その結果も表に載せています。
- 音声付き 5.17 秒の動画
- 57–76s
- fl2va · 2026-10-18 に 4 回実測 · テキスト DGX Spark · DiT と映像 RTX 5080 · 音声 RTX 3060
- 最速の DiT ステージ(コールドロード後の初回呼び出し)
- 33.2s
- ノイズ除去の計算は 26.0 s · INT8 · PAI 8 ステップ · RTX 5080
- 完走した DiT エンジン
- 37/40
- 同じ RTX 5080 で合計 3.2 時間 · NF4 の 3 種は読み込みに失敗し、失敗として記載
すべての速度に、各ステップを実行したマシンを明記しています。古い実験の記録に残っていないものは「実行デバイス未記録」と表示します。
自分のハードウェアに合う設定を探すまだのものは、はっきりと。
テスト中、近日追加予定、設計目標。すべてに状態を表示しています。開発の順番は、私自身の必要に合わせて決めています。
- テスト中
ワンクリック差し替え
5 ステップのウィザードはできていますが、動画全体での実行はまだです。権利を持つ素材だけを使い、実在の人物になりすまさないでください。
- 実装済み・未検証
動画からプロンプトへ
実装済みですが、実モデルでの検証はまだです。
- 近日追加予定
背景除去
Image Studio で、そのまま背景を除去できるようにします。
- 設計目標
マシンを 1〜2 時間だけ借りる
デプロイ、起動、処理、書き出し、シャットダウン。使い終わったら止めます。まだパッケージ化していません。
- 開発中
マルチレベルレンダリング · TTS と音声変換 · 超解像とフレーム補間
簡単な画で素早くカットを決めてから、キャラクターを入れて仕上げます。自作の TTS システム。いくつかの超解像・フレーム補間の技術を統合中です。
- 計画中
生成プラグインとスライダー · 対応モデルの拡充 · VAE と DiT の最適化
スライダーや LoRA スタイルによる細かな制御、Suno の音楽などサードパーティのモデルの接続。映像 VAE のエンコードとデコードは、今も負荷が大きすぎます。
ArtCraft の機能も参考にしていますが、まだ統合していません。
進捗をフォロー今すぐ使える?
- ダウンロード
- まだできません。現在はダウンロードもインストーラーもなく、登録や支払いも必要ありません。ソースコードは整理でき次第、Apache-2.0 で公開します。
- パソコン
- NVIDIA の GPU が必要です。実行環境が対応しているのは RTX 50 シリーズ、RTX 30 シリーズ、DGX Spark(GB10)だけで、RTX 40 シリーズと Mac にはまだ対応していません。参照素材から動画を生成する場合、16 GB の GPU ではかなり厳しくなります(実測のピークは GPU 全体で 15.91 GiB)。
- 費用
- ソースコードは公開後、Apache-2.0 で無料で使えます。モデルの重みは同梱しないため、各自で入手し、それぞれのライセンスに従ってください。
- 商用利用
- Qwen‑Image 2.1 は研究・非商用の用途に限られ、MiniMax H3 のライセンス対象地域は EU・英国・韓国・米国を除き、利用規定もあります。収益化したチャンネル、タイアップ、受託制作に使う前に、ライセンスを確認してください。
- 最新情報
- GitHub か Hugging Face で phasyn をフォローするか、[email protected] までメールをお送りください。
Phasyn Studio はフレームワークです。モデルの重みを同梱・配布することはありません。モデルは各自で用意し、それぞれのライセンスに従って使ってください。
あなたのアイデアを、動く映像に。
ソースコードとアーキテクチャ解説は近日公開です。リリースは GitHub の phasyn で、新しい映像素材は Hugging Face でお知らせします。ご意見はメールでお気軽にどうぞ。
ソースコードとアーキテクチャ解説を近日公開このプロジェクトについて