

市面上的影片生成
- 一張 1152×672 靜態圖,端對端
- ≈26s
- 一段 5.17 秒有聲影片,端對端
- 57–76s
- 一次渲染:兩台機器、三顆 GPU
- 2 · 3
- 在同一張 RTX 5080 上跑完的 H3 DiT 變體
- 37/40
2026-10-18 實測。靜態圖:4 次 t2i 渲染 25.8–26.9 秒,文字編碼、DiT 與 VAE 在 RTX 5080,合成在 CPU。影片:4 次 fl2va 渲染,文字編碼在 DGX Spark(GB10),DiT 與影片解碼在 RTX 5080,音訊在 RTX 3060。
一個角色,13個實際輸出。
原創角色 The Courier:從角色設定稿、靜態圖,到有聲音的影片片段,全部用 Phasyn Studio 在兩台機器上渲染。總渲染時間大約 11 分鐘。
含 AI 生成內容(MiniMax H3、Qwen-Image 2.1)
四張靜態圖,四段有聲影片。
 AI 生成 · Powered by MiniMax H3
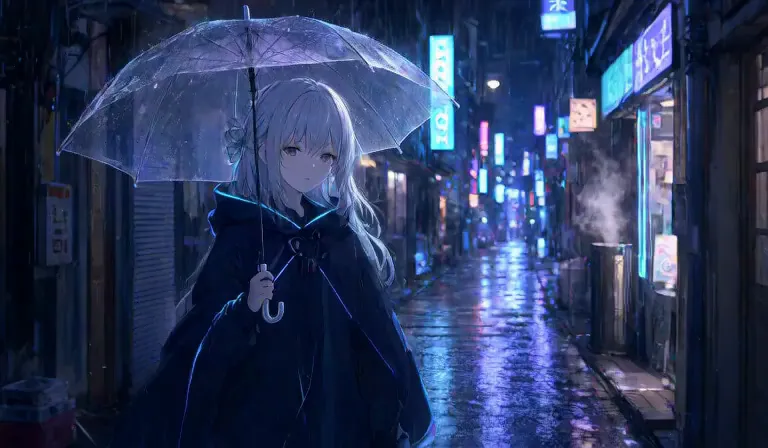
雨夜的巷子fl2va · seed 202 · 端對端 57.2 秒文字 GB10 · DiT 與影片 RTX 5080 · 音訊 RTX 3060 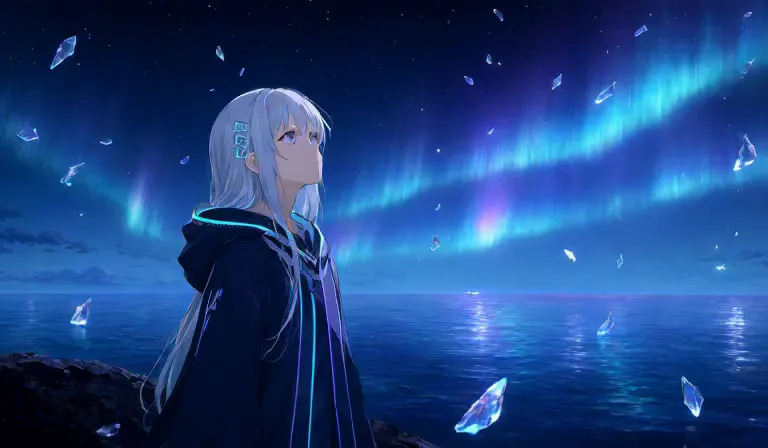 AI 生成 · Powered by MiniMax H3
極光下的海fl2va · seed 303 · 端對端 57.4 秒文字 GB10 · DiT 與影片 RTX 5080 · 音訊 RTX 3060 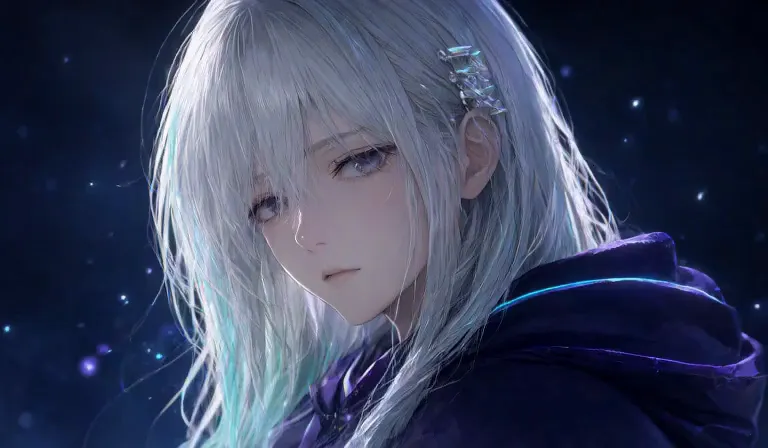 AI 生成 · Powered by MiniMax H3
在微光中醒來fl2va · seed 404 · 端對端 58.6 秒文字 GB10 · DiT 與影片 RTX 5080 · 音訊 RTX 3060 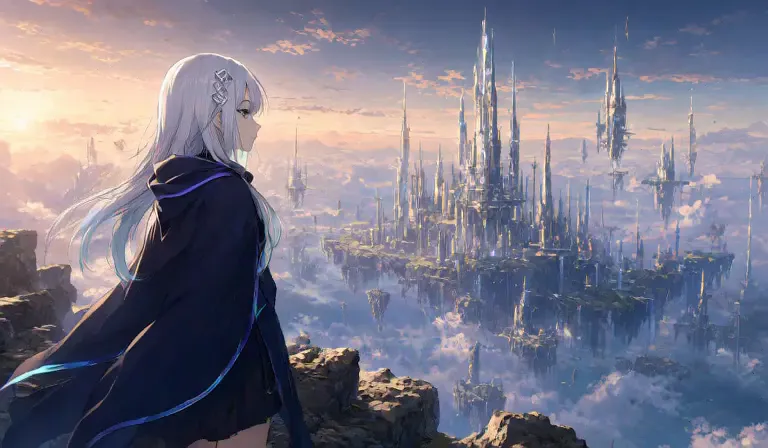 AI 生成 · Powered by MiniMax H3
黎明的懸崖fl2va · seed 101 · 端對端 76 秒文字 GB10 · DiT 與影片 RTX 5080 · 音訊 RTX 3060
時間是 Controller 記錄的端對端時間,不含模型啟動(每次切換 11–46 秒)。影片原始輸出為 768×448;網頁版只做了響度正規化(原始約 −37~−50 LUFS、AAC 32 kHz)。
看全部成果為什麼要自己開發?
- 市面上的影片生成
服務, 又爛又貴, 還要你買點數。 - 本地方案,
例如 ComfyUI, 完全不考慮真正的 操作需求 與 加速需求。
文字、圖片、影片,一條流程。
從一句提示詞,到一段有聲影片。每一步都看得見,每一步都能調整。
- 01文字
從一句話開始。
寫下提示詞。Image Studio 用它生成畫面;在 Video Studio 裡,可以用 @Image1、@Video1、@Audio1 指定參考素材,片段庫、區塊檢視與格式化工具都在手邊。
- 提示詞
- @ 參考素材
- 片段庫
- 02圖片
先把畫面定下來。
在 Image Studio 以 Qwen‑Image 2.1 生成圖片。每次生成都留成一個 take,可以並排比較,再挑一張當影片鏡頭的首幀。
- 文字生成圖片
- 圖生圖
- 遮罩編輯
- 03影片
讓它動起來,連聲音一起。
文字、圖片、影片與聲音都能當作參考。MiniMax H3 同時生成畫面與同步的聲音。
- t2va · 文字
- fl2va · 首幀
- ref2va · 參考素材
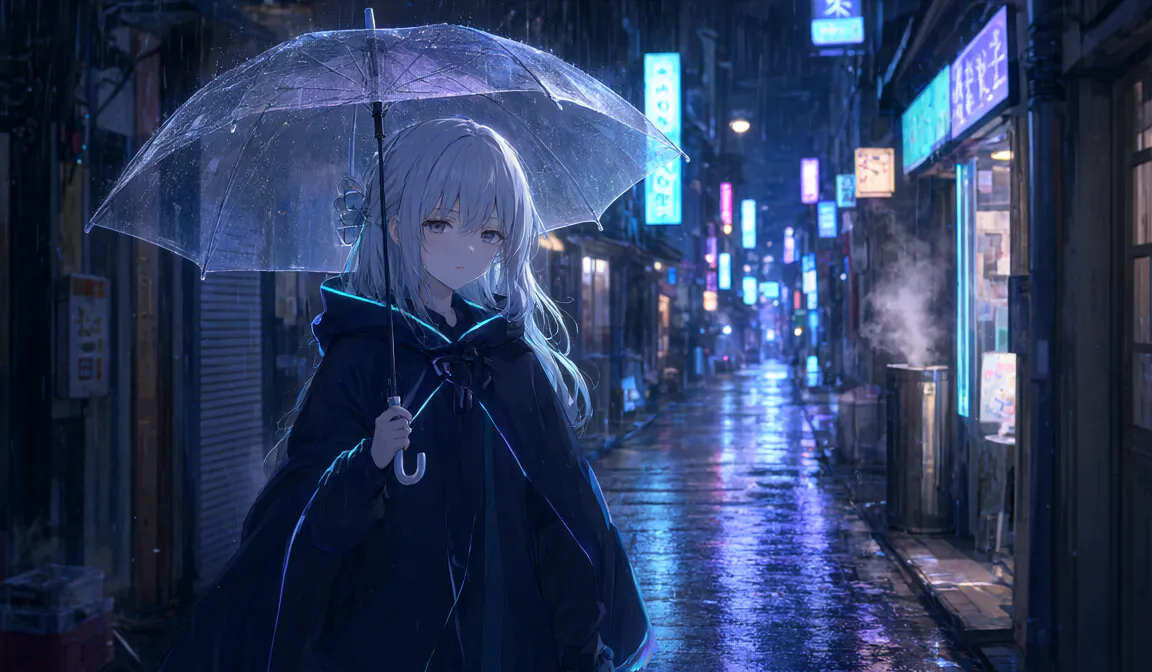 AI 生成 · Powered by MiniMax H3實際輸出
 首幀H3 fl2va768×448 · 5.17 s · cfa759dfAI 生成 · Qwen-Image 2.1
實際輸出:以這張 Qwen‑Image 2.1 靜態圖為首幀,H3 fl2va 生成了含聲音的影片(run cfa759df)。網頁版已做響度正規化;原始輸出約 −37~−50 LUFS、AAC 32 kHz。
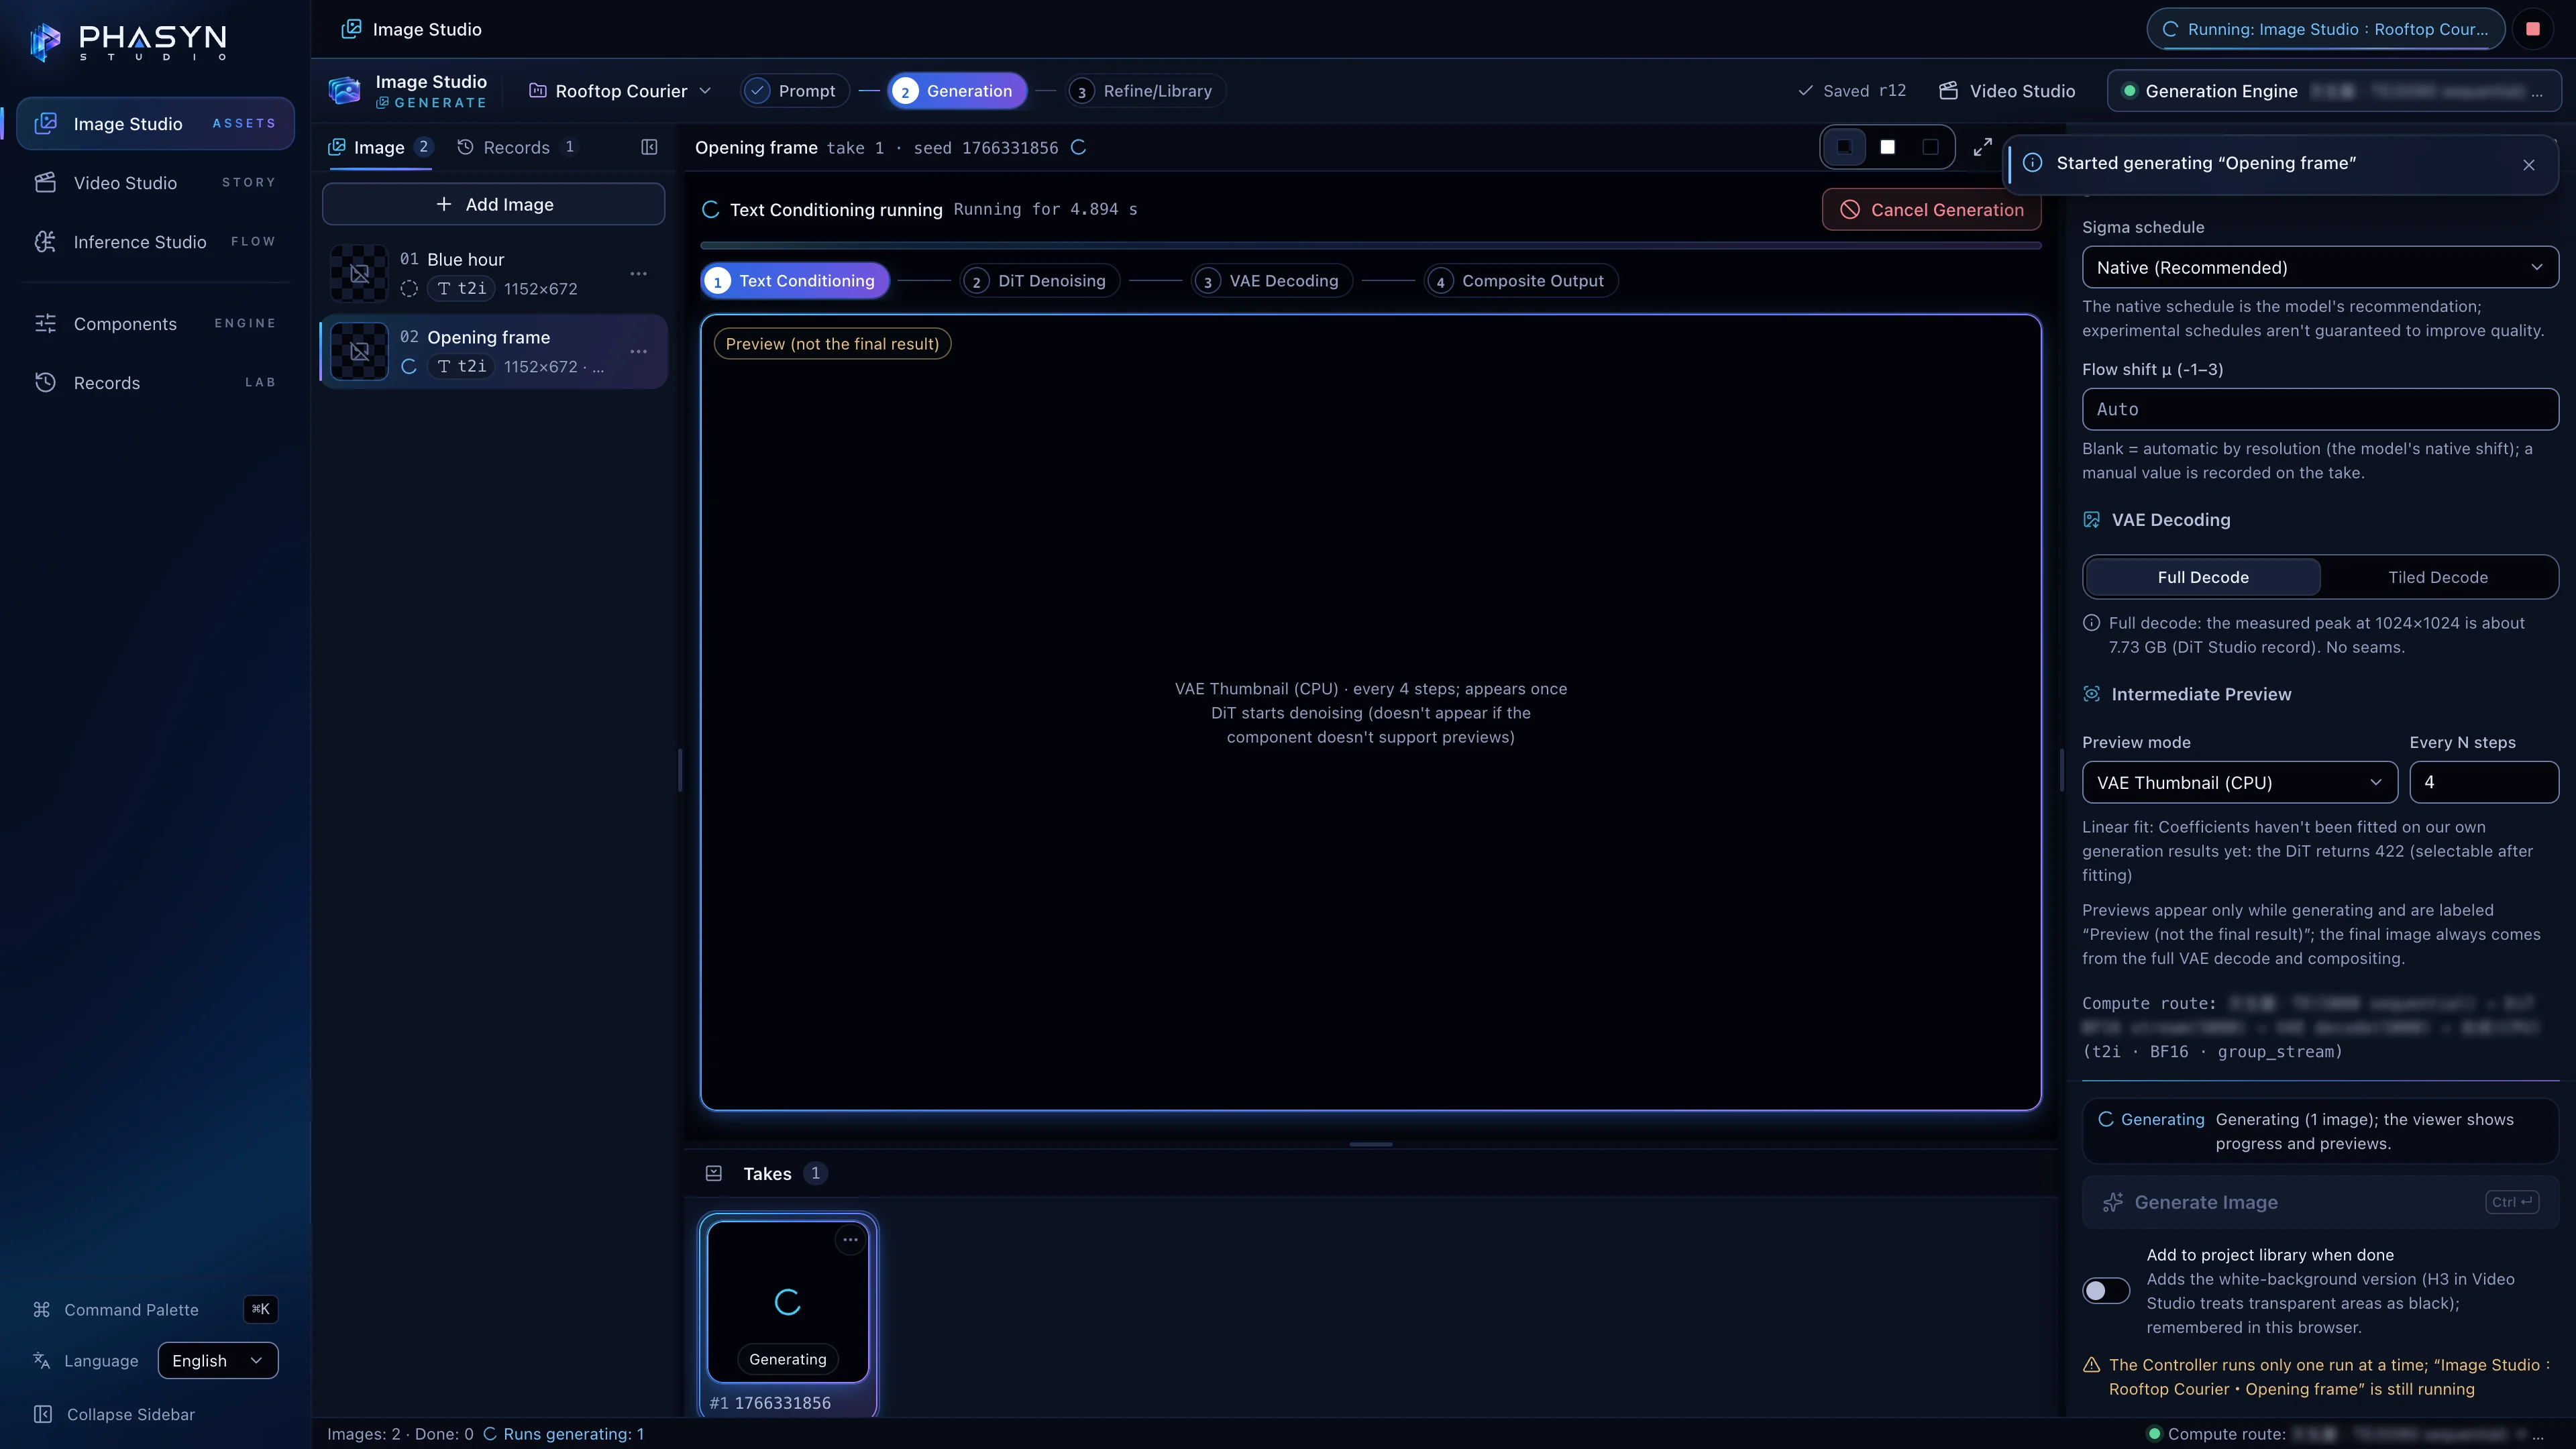
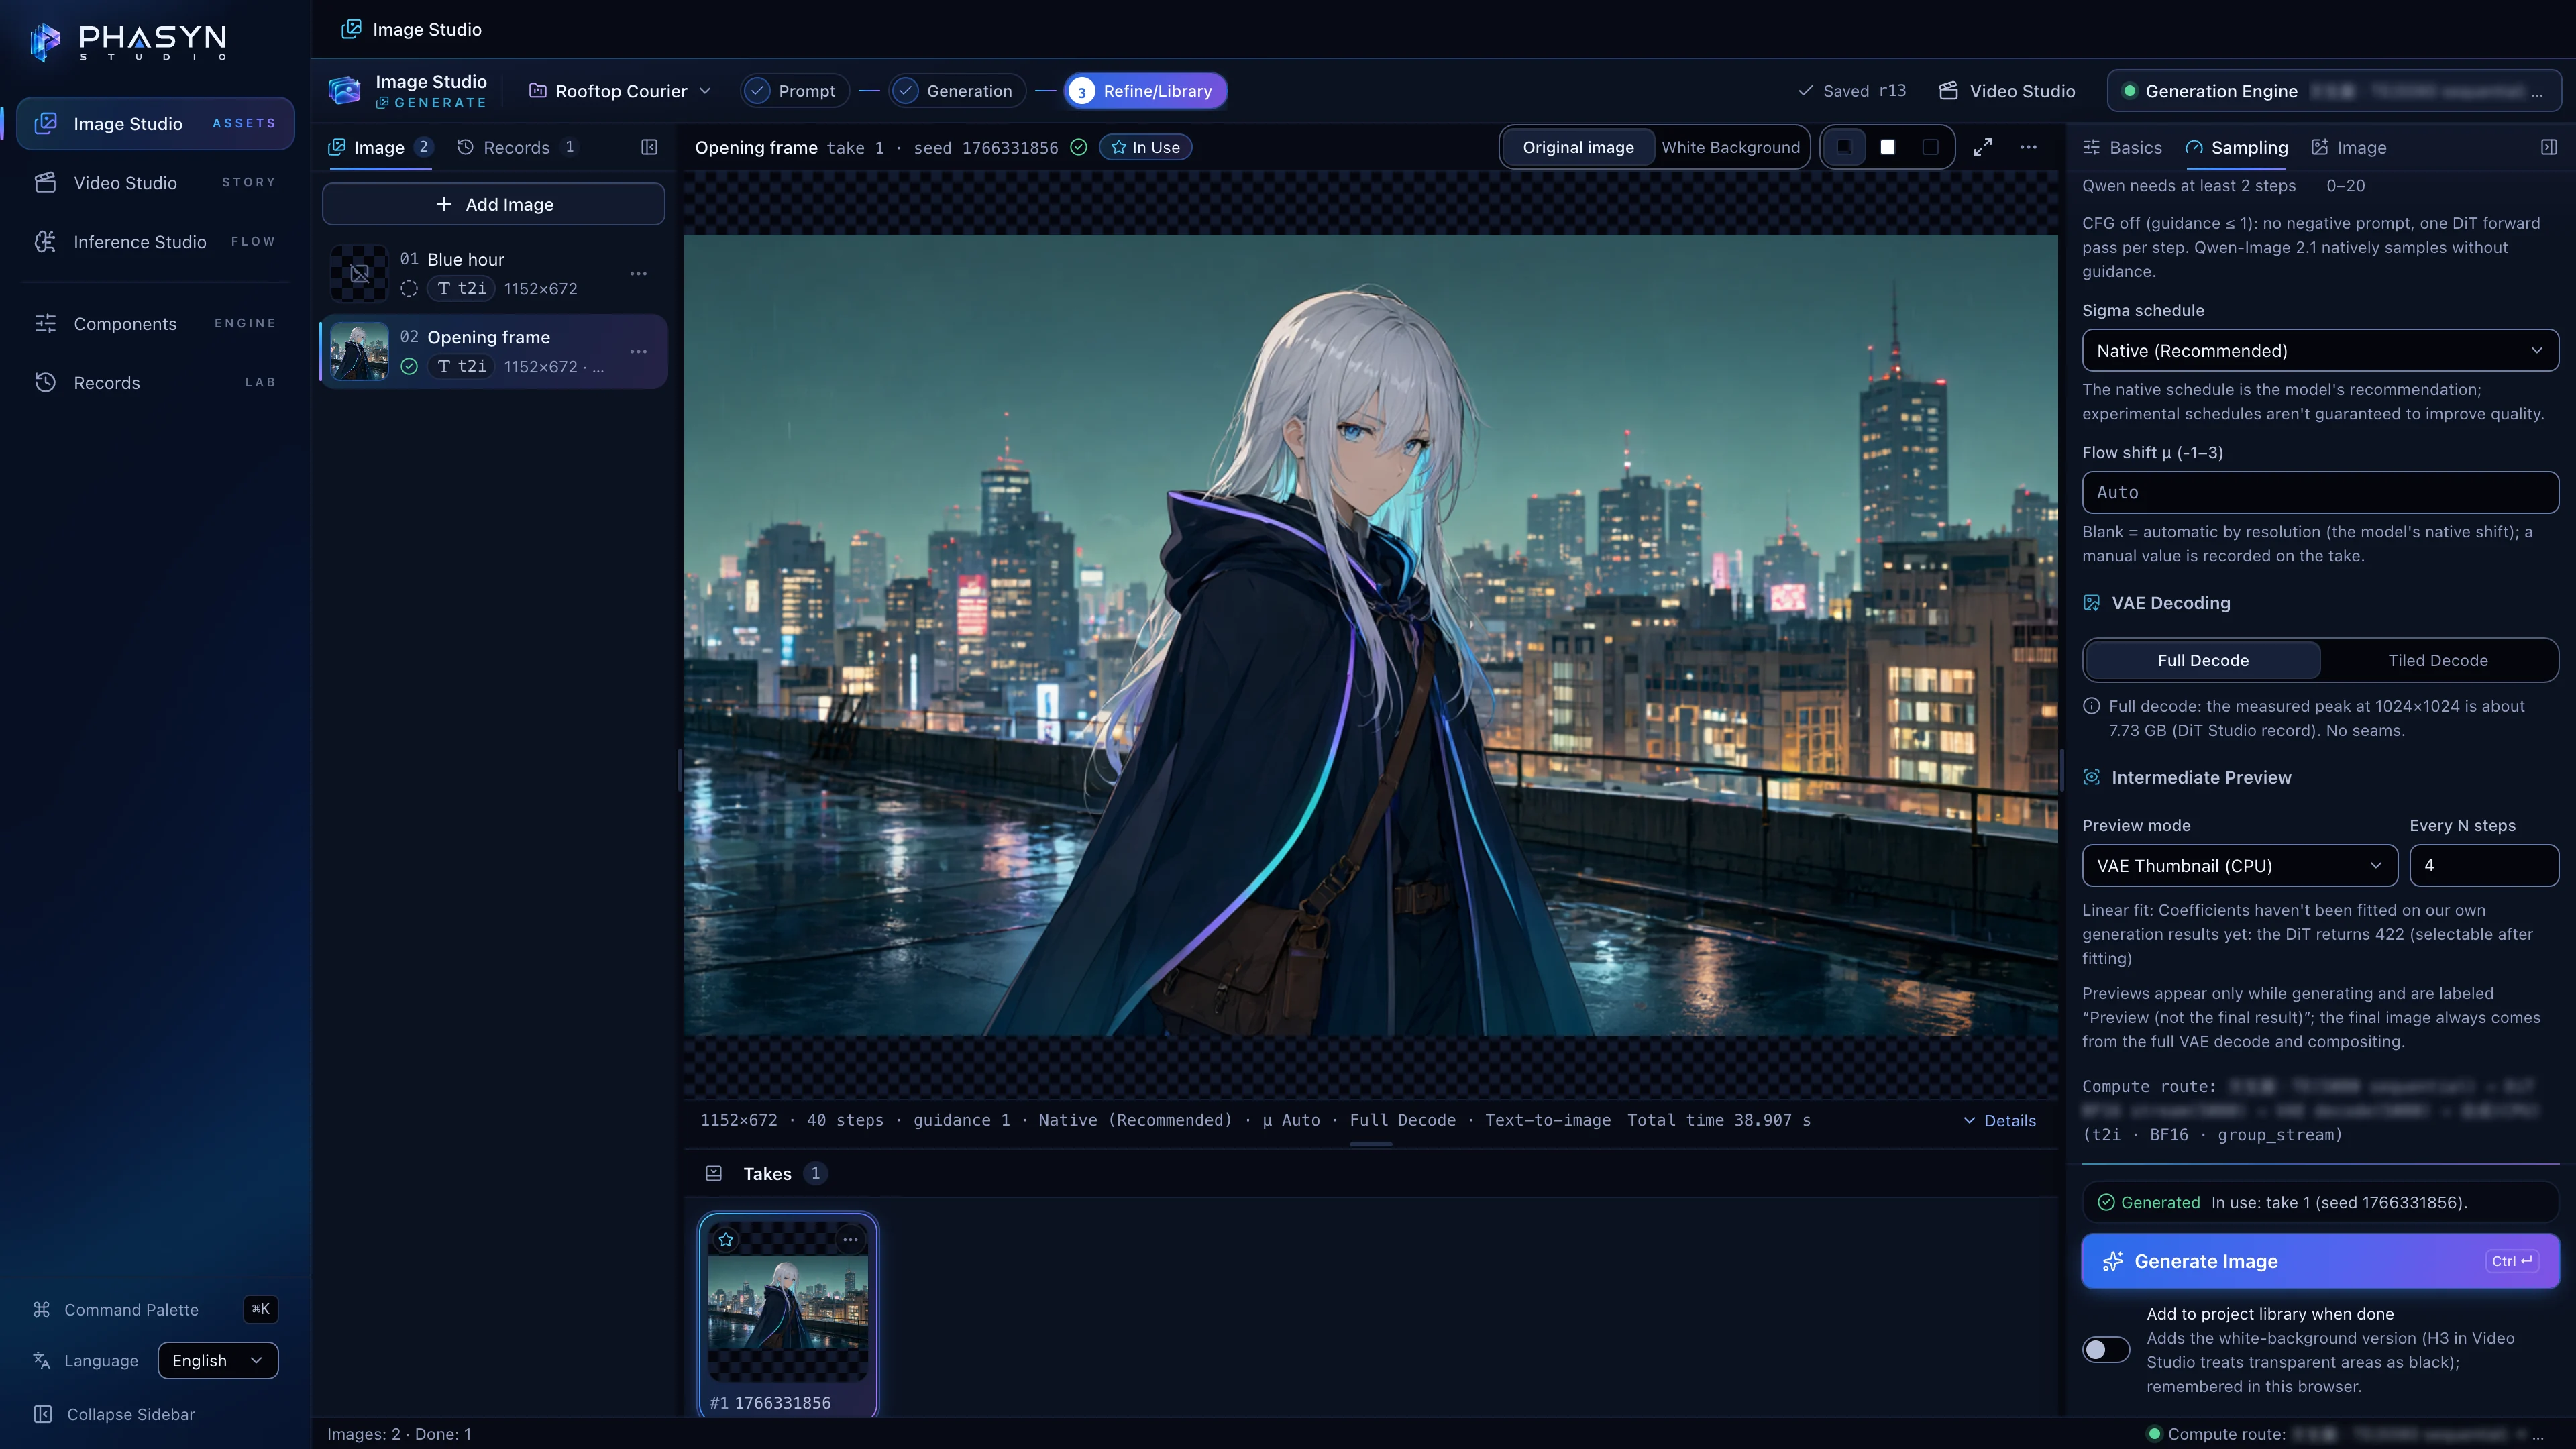
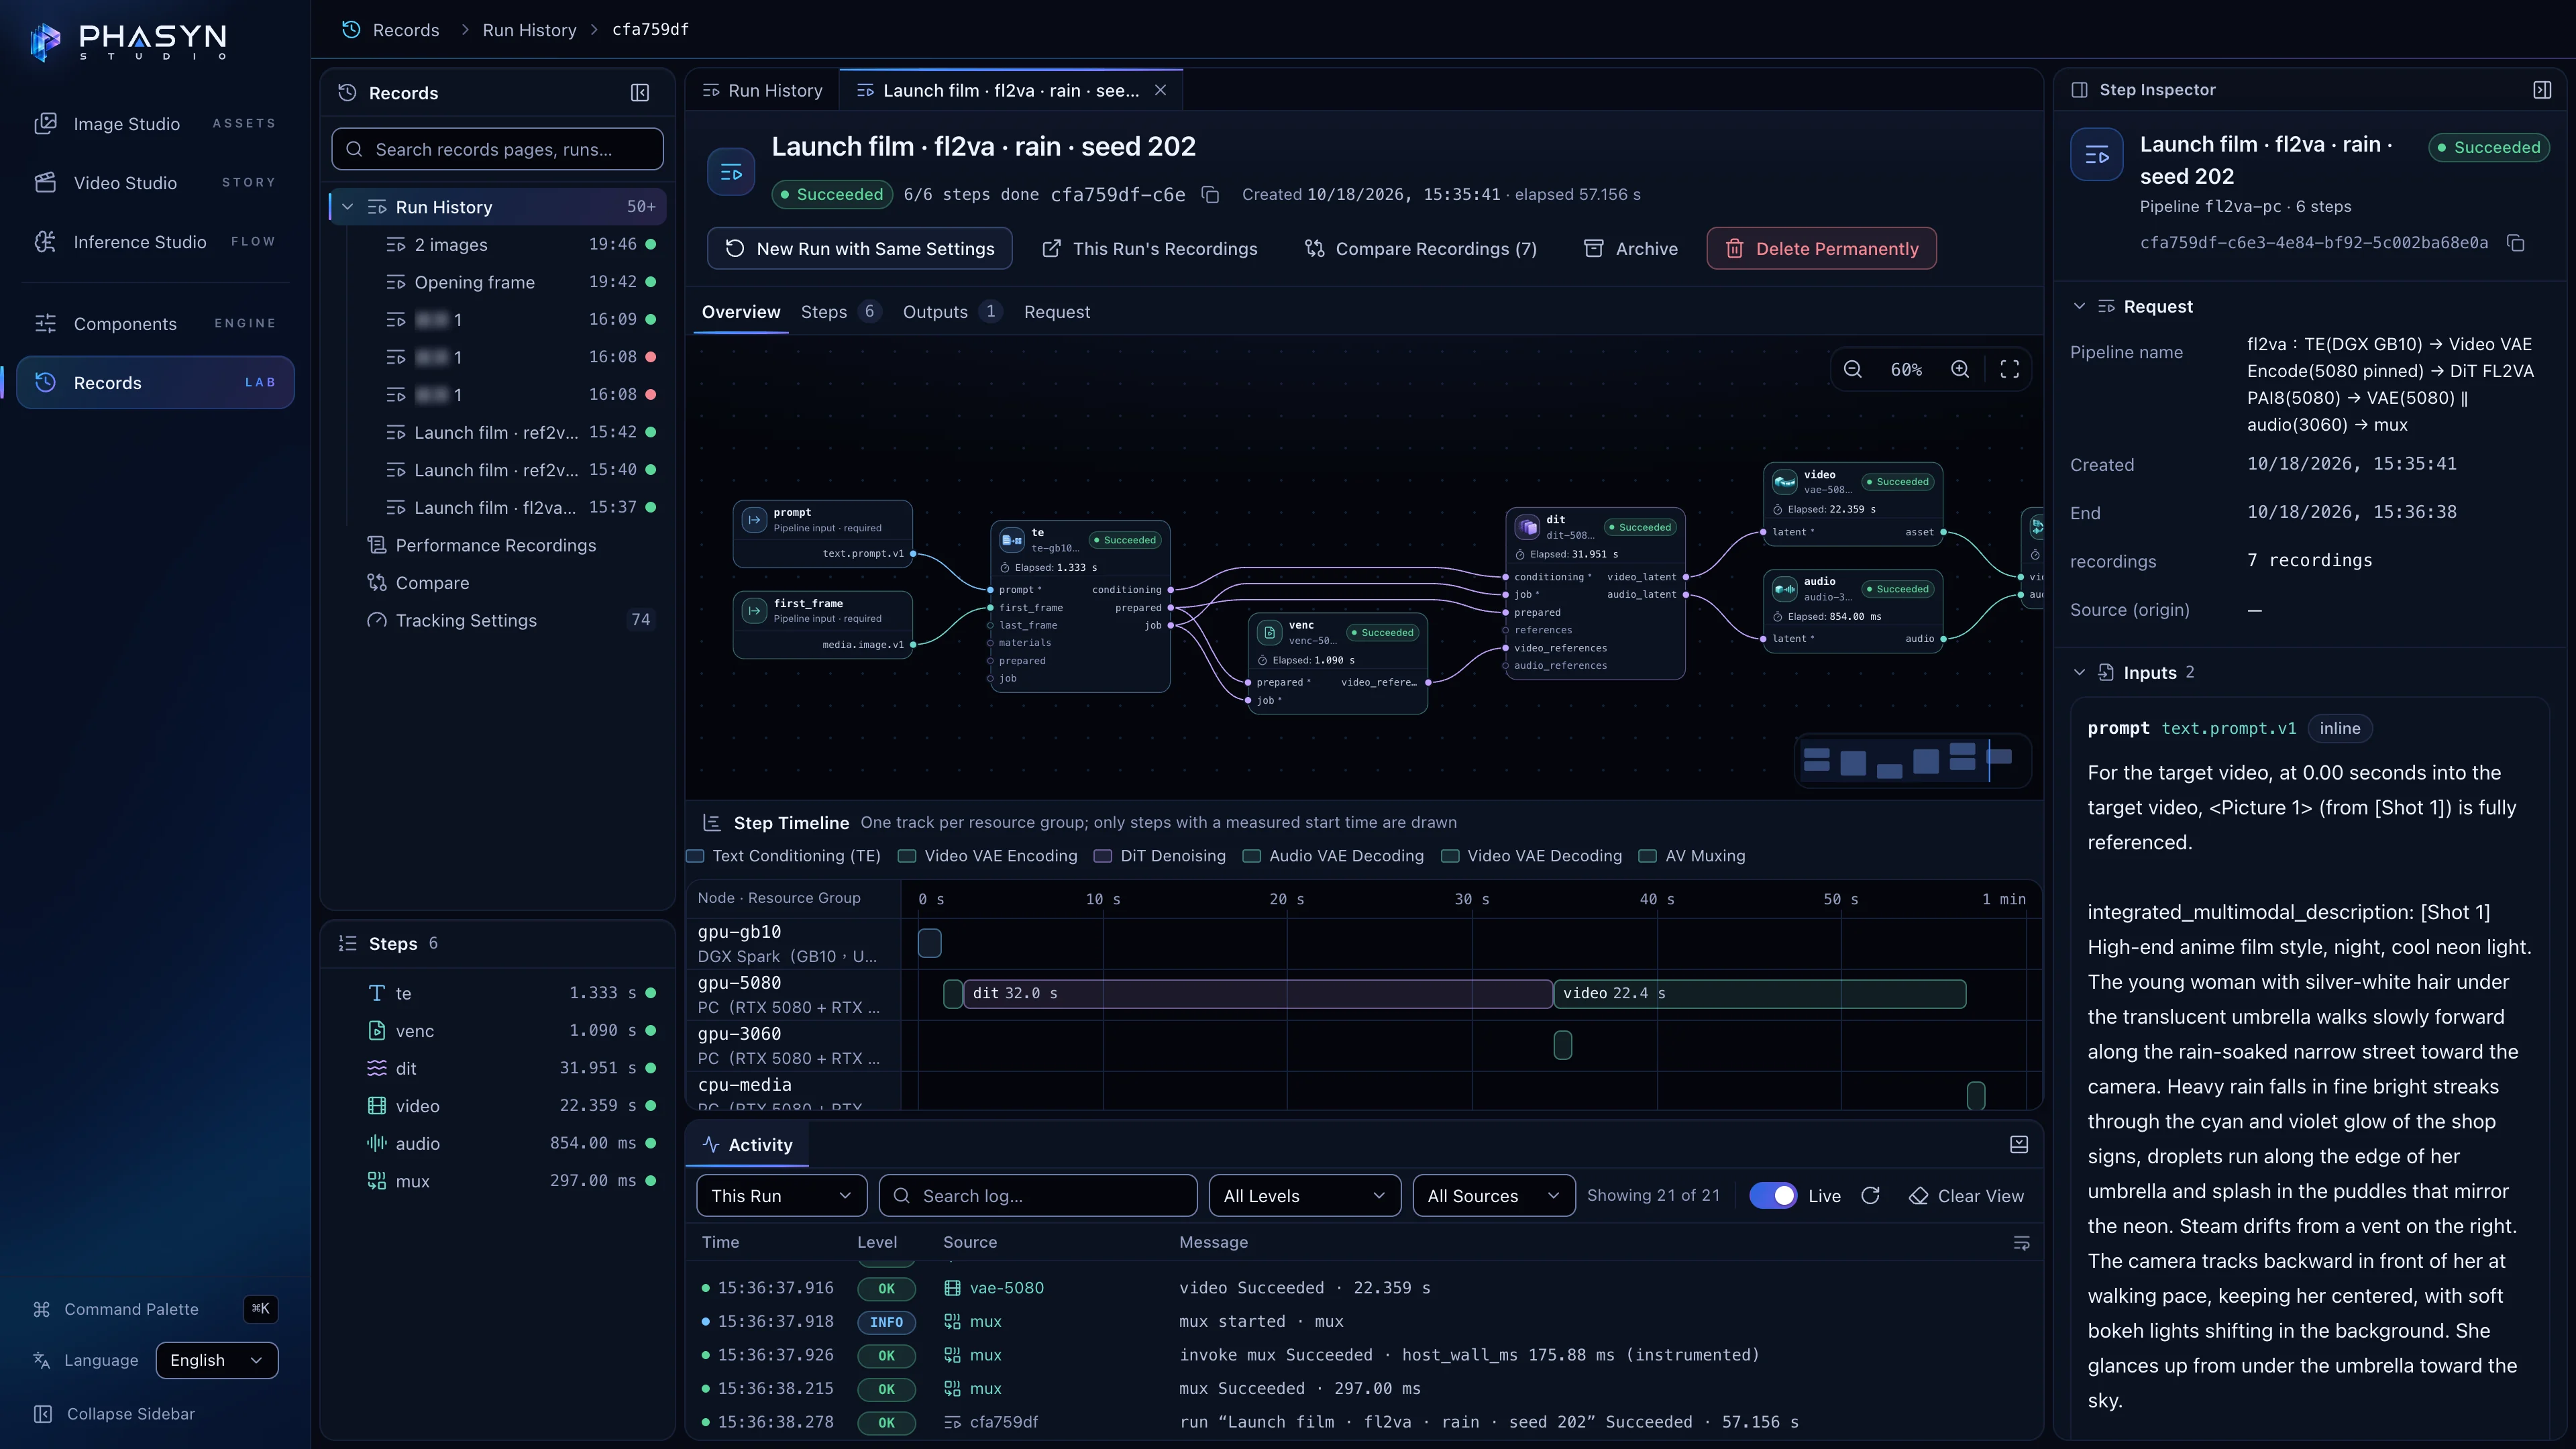
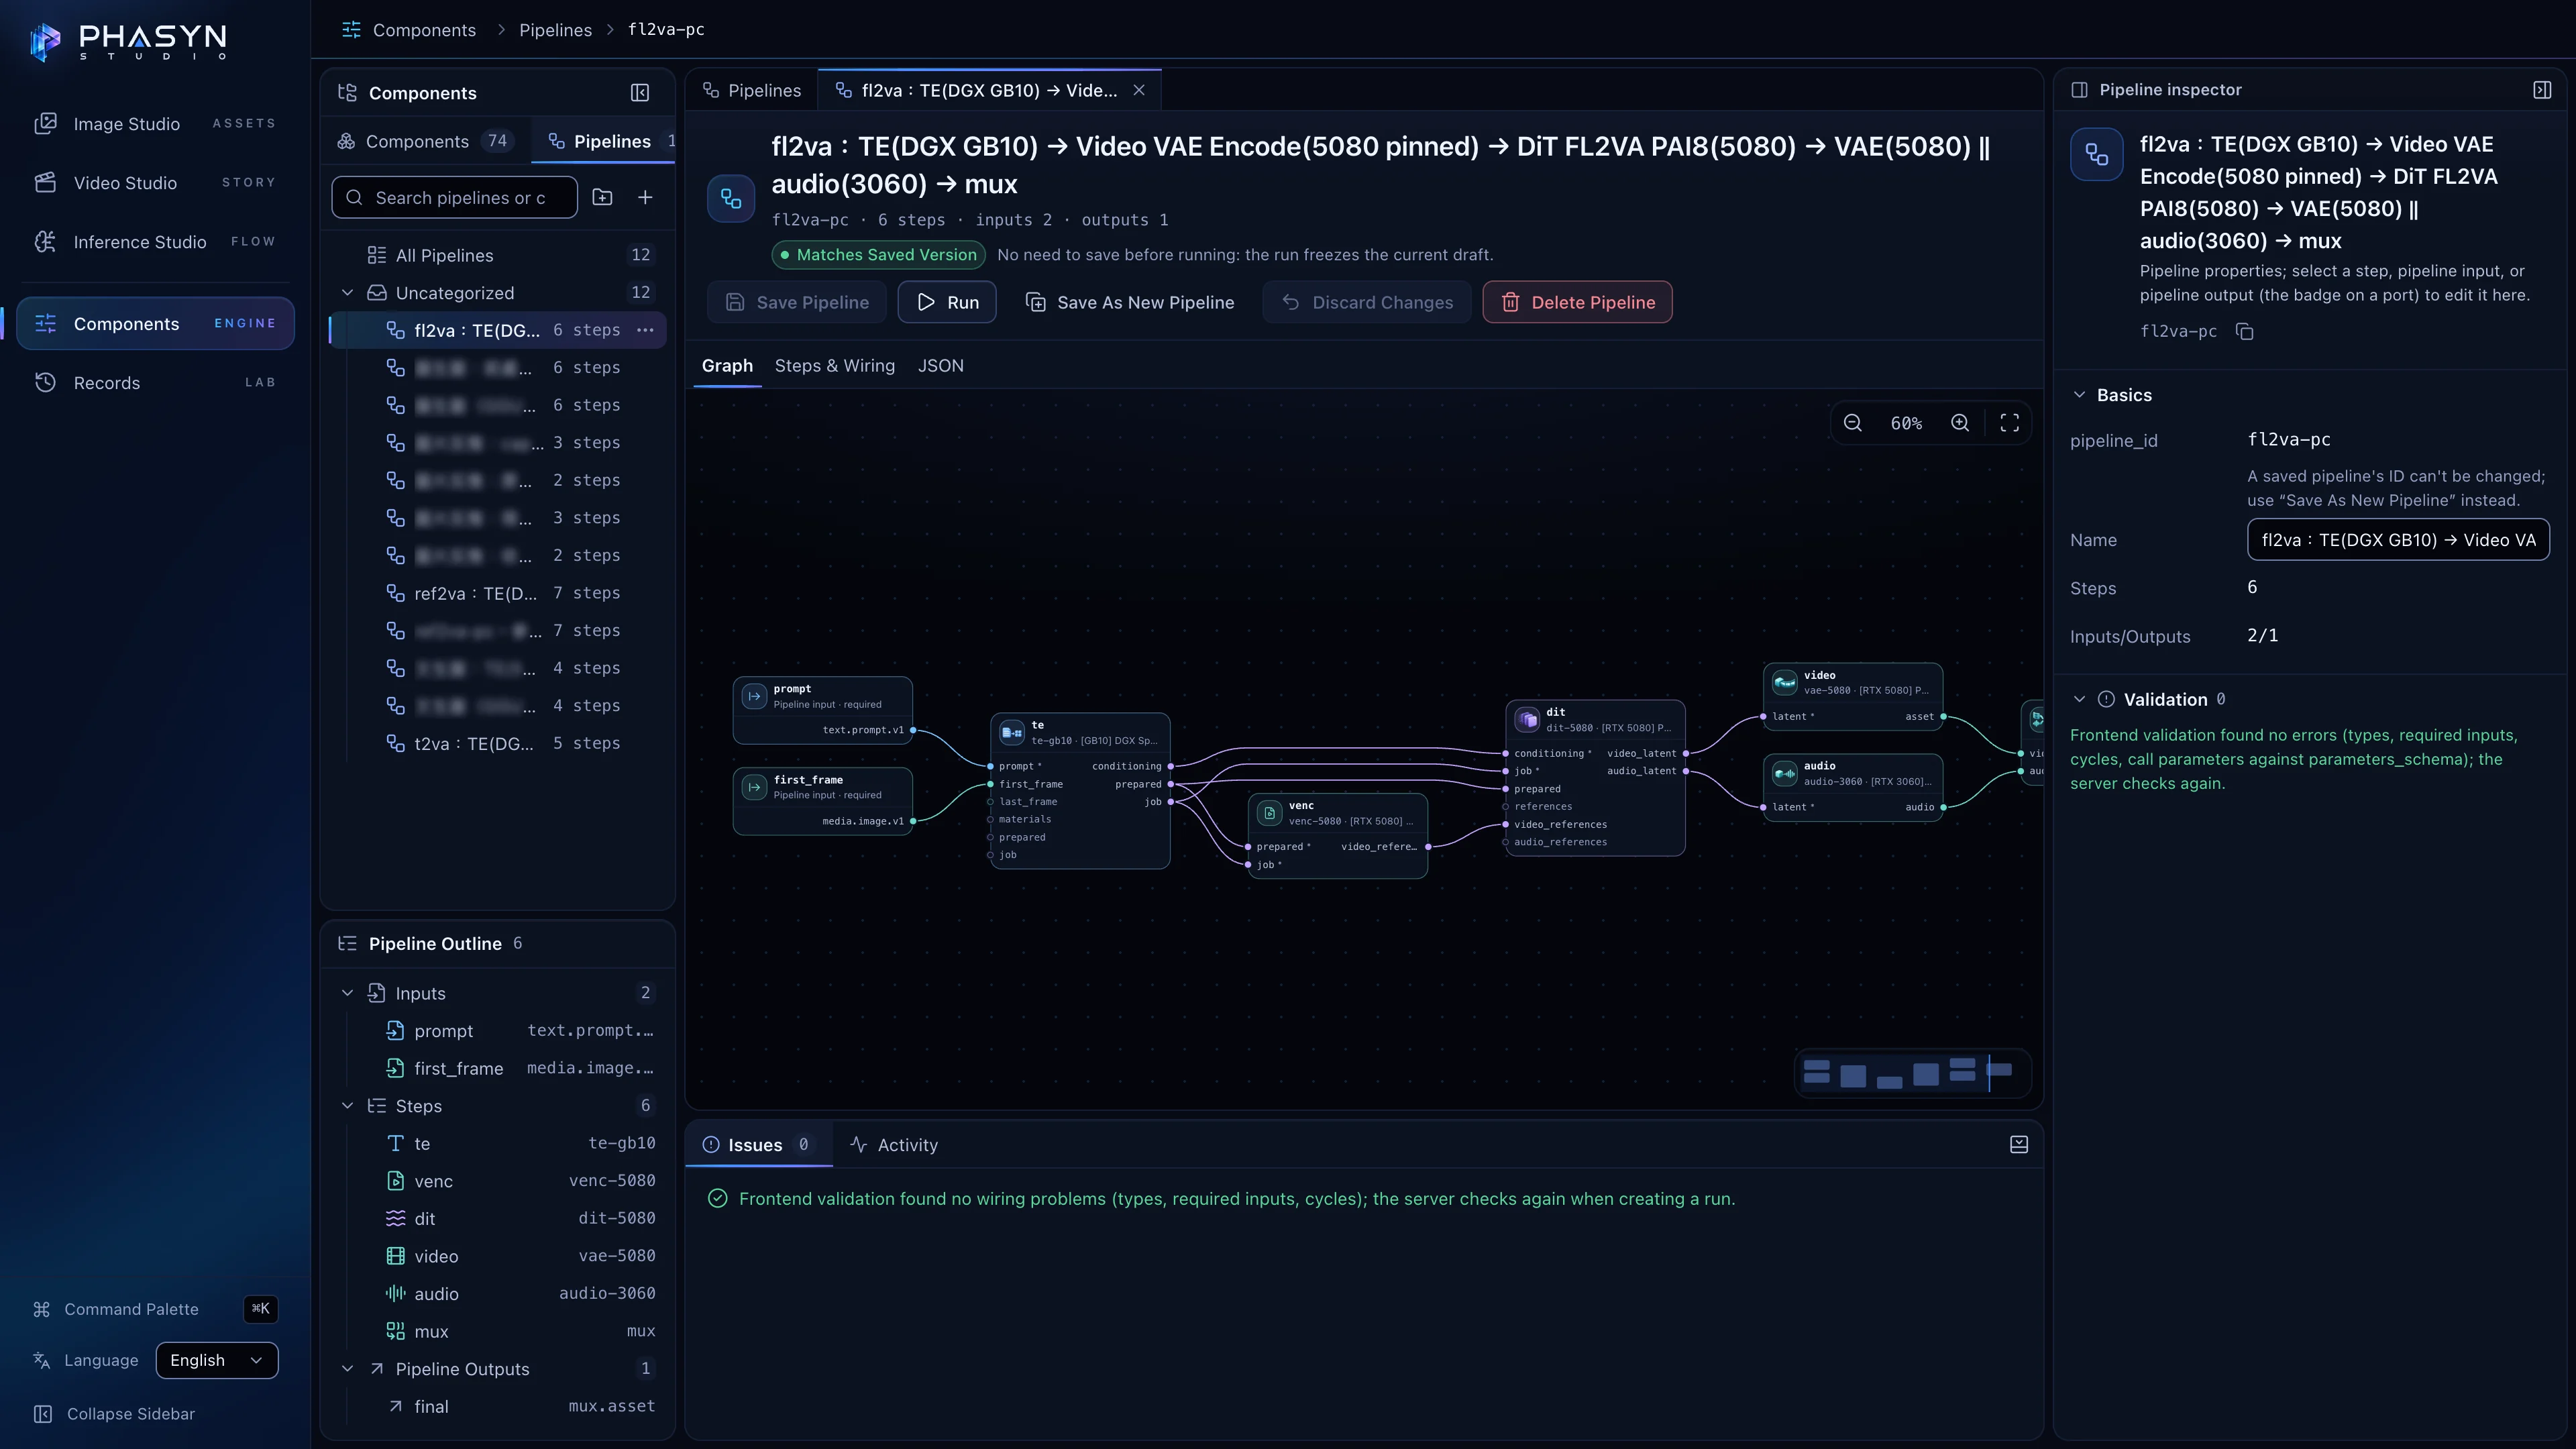
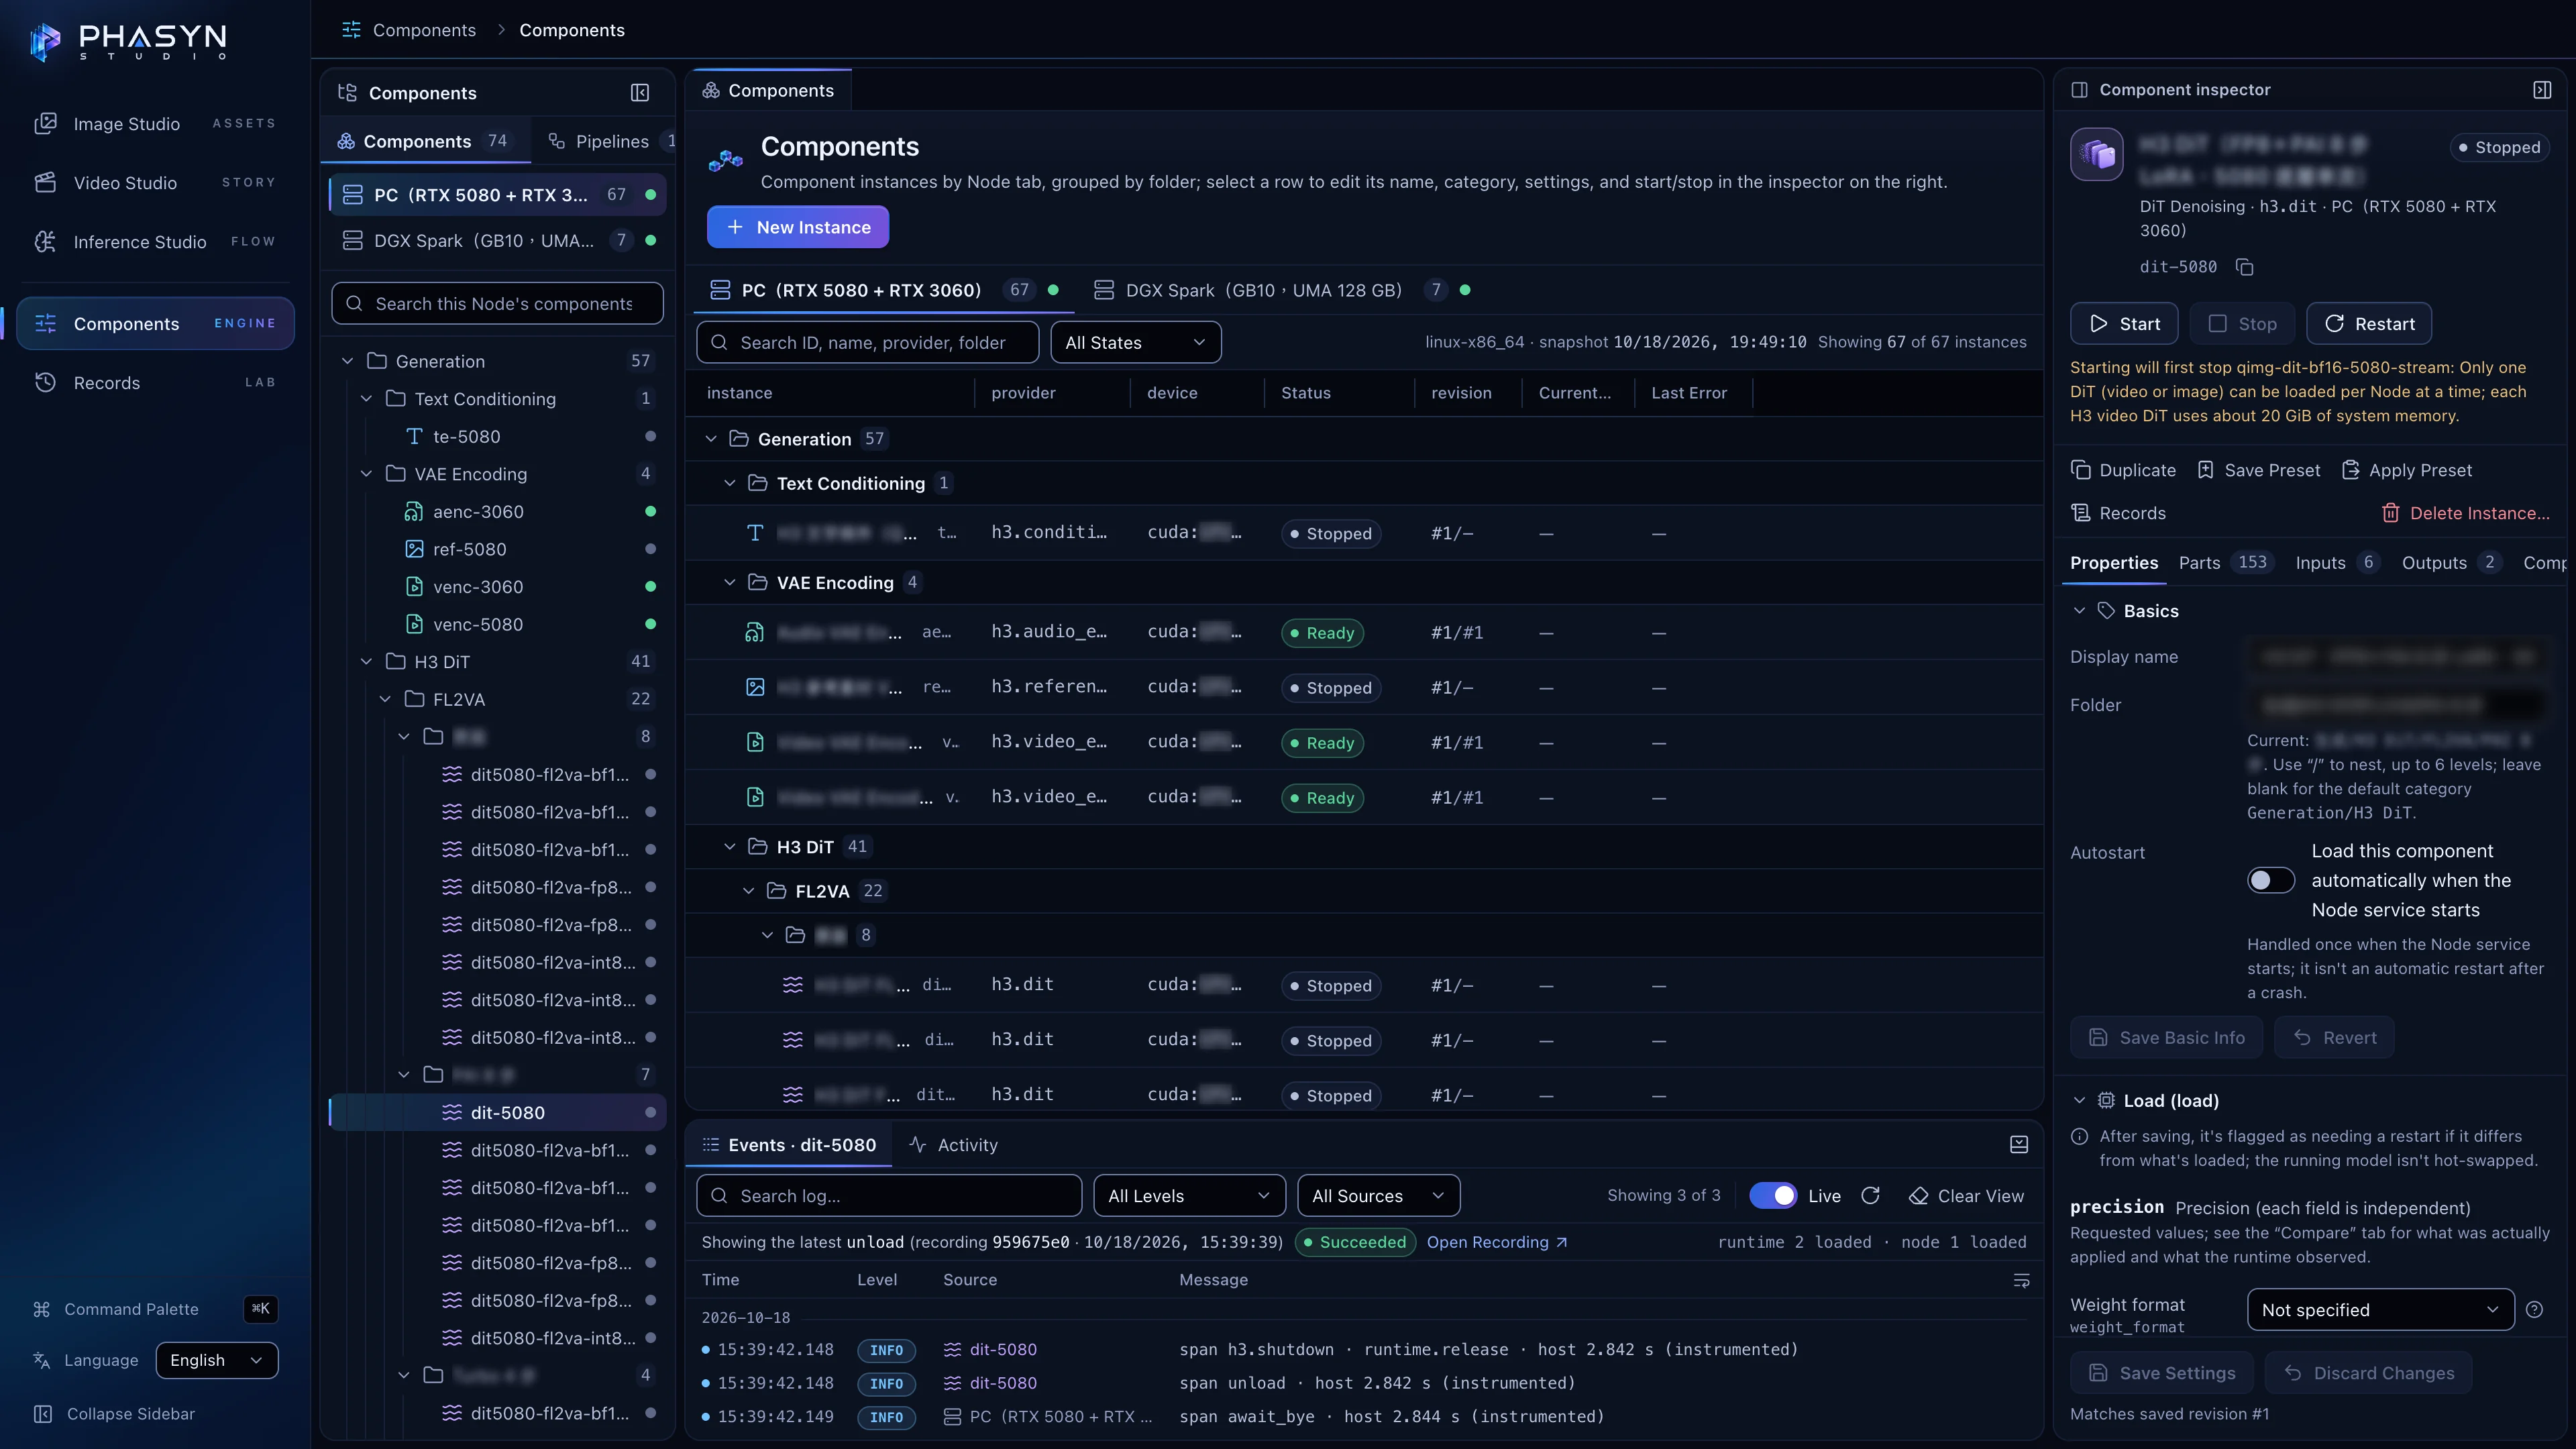
介面是 Phasyn Studio 的實際畫面(英文介面)。靜態圖與影片是實際輸出。靜態圖:以 Image Studio 所用的 t2i‑pc 管線、Qwen‑Image 2.1 生成(1152×672,端對端約 27 秒:文字編碼、DiT 與 VAE 在 RTX 5080,合成在 CPU)。影片:以這張圖為首幀,用 H3 fl2va 生成(768×448、24 fps、124 幀=5.17 秒、含生成的聲音)。它就是下方 Records 畫面裡的 run cfa759df,端對端 57.2 秒:文字編碼在 DGX Spark GB10,DiT 與影片解碼在 RTX 5080,音訊解碼在 RTX 3060。
為真正的創作而做。
每個功能,都從實際的需求出發。
Prompt Advisor
74 條規則邊寫邊檢查:45 條來自 MiniMax 官方指南、21 條來自實際安裝的程式碼、8 條來自寫作指南。其中 21 條可以一鍵修正,套用前先看差異。每條規則都標出來源。
@ 參考素材
用 @Image1、@Video1、@Audio1 指定參考素材,直接對應到 H3 自己的標籤。
時間軸與匯出
分割、吸附、交叉溶解、變速、調色、標題,最後用 FFmpeg 匯出 MP4。
2026-10-18 實測的輸出:768×448、24 fps、124 幀(5.17 秒),聲音 AAC 32 kHz 立體聲。匯出:MP4(H.264+AAC,完整重新編碼;畫質預設 CRF 18/23/28)。
圖片反推提示詞
丟一張圖進去,DGX Spark 上的視覺模型會寫回場景描述與候選提示詞。
一次渲染,兩台機器,三顆 GPU。
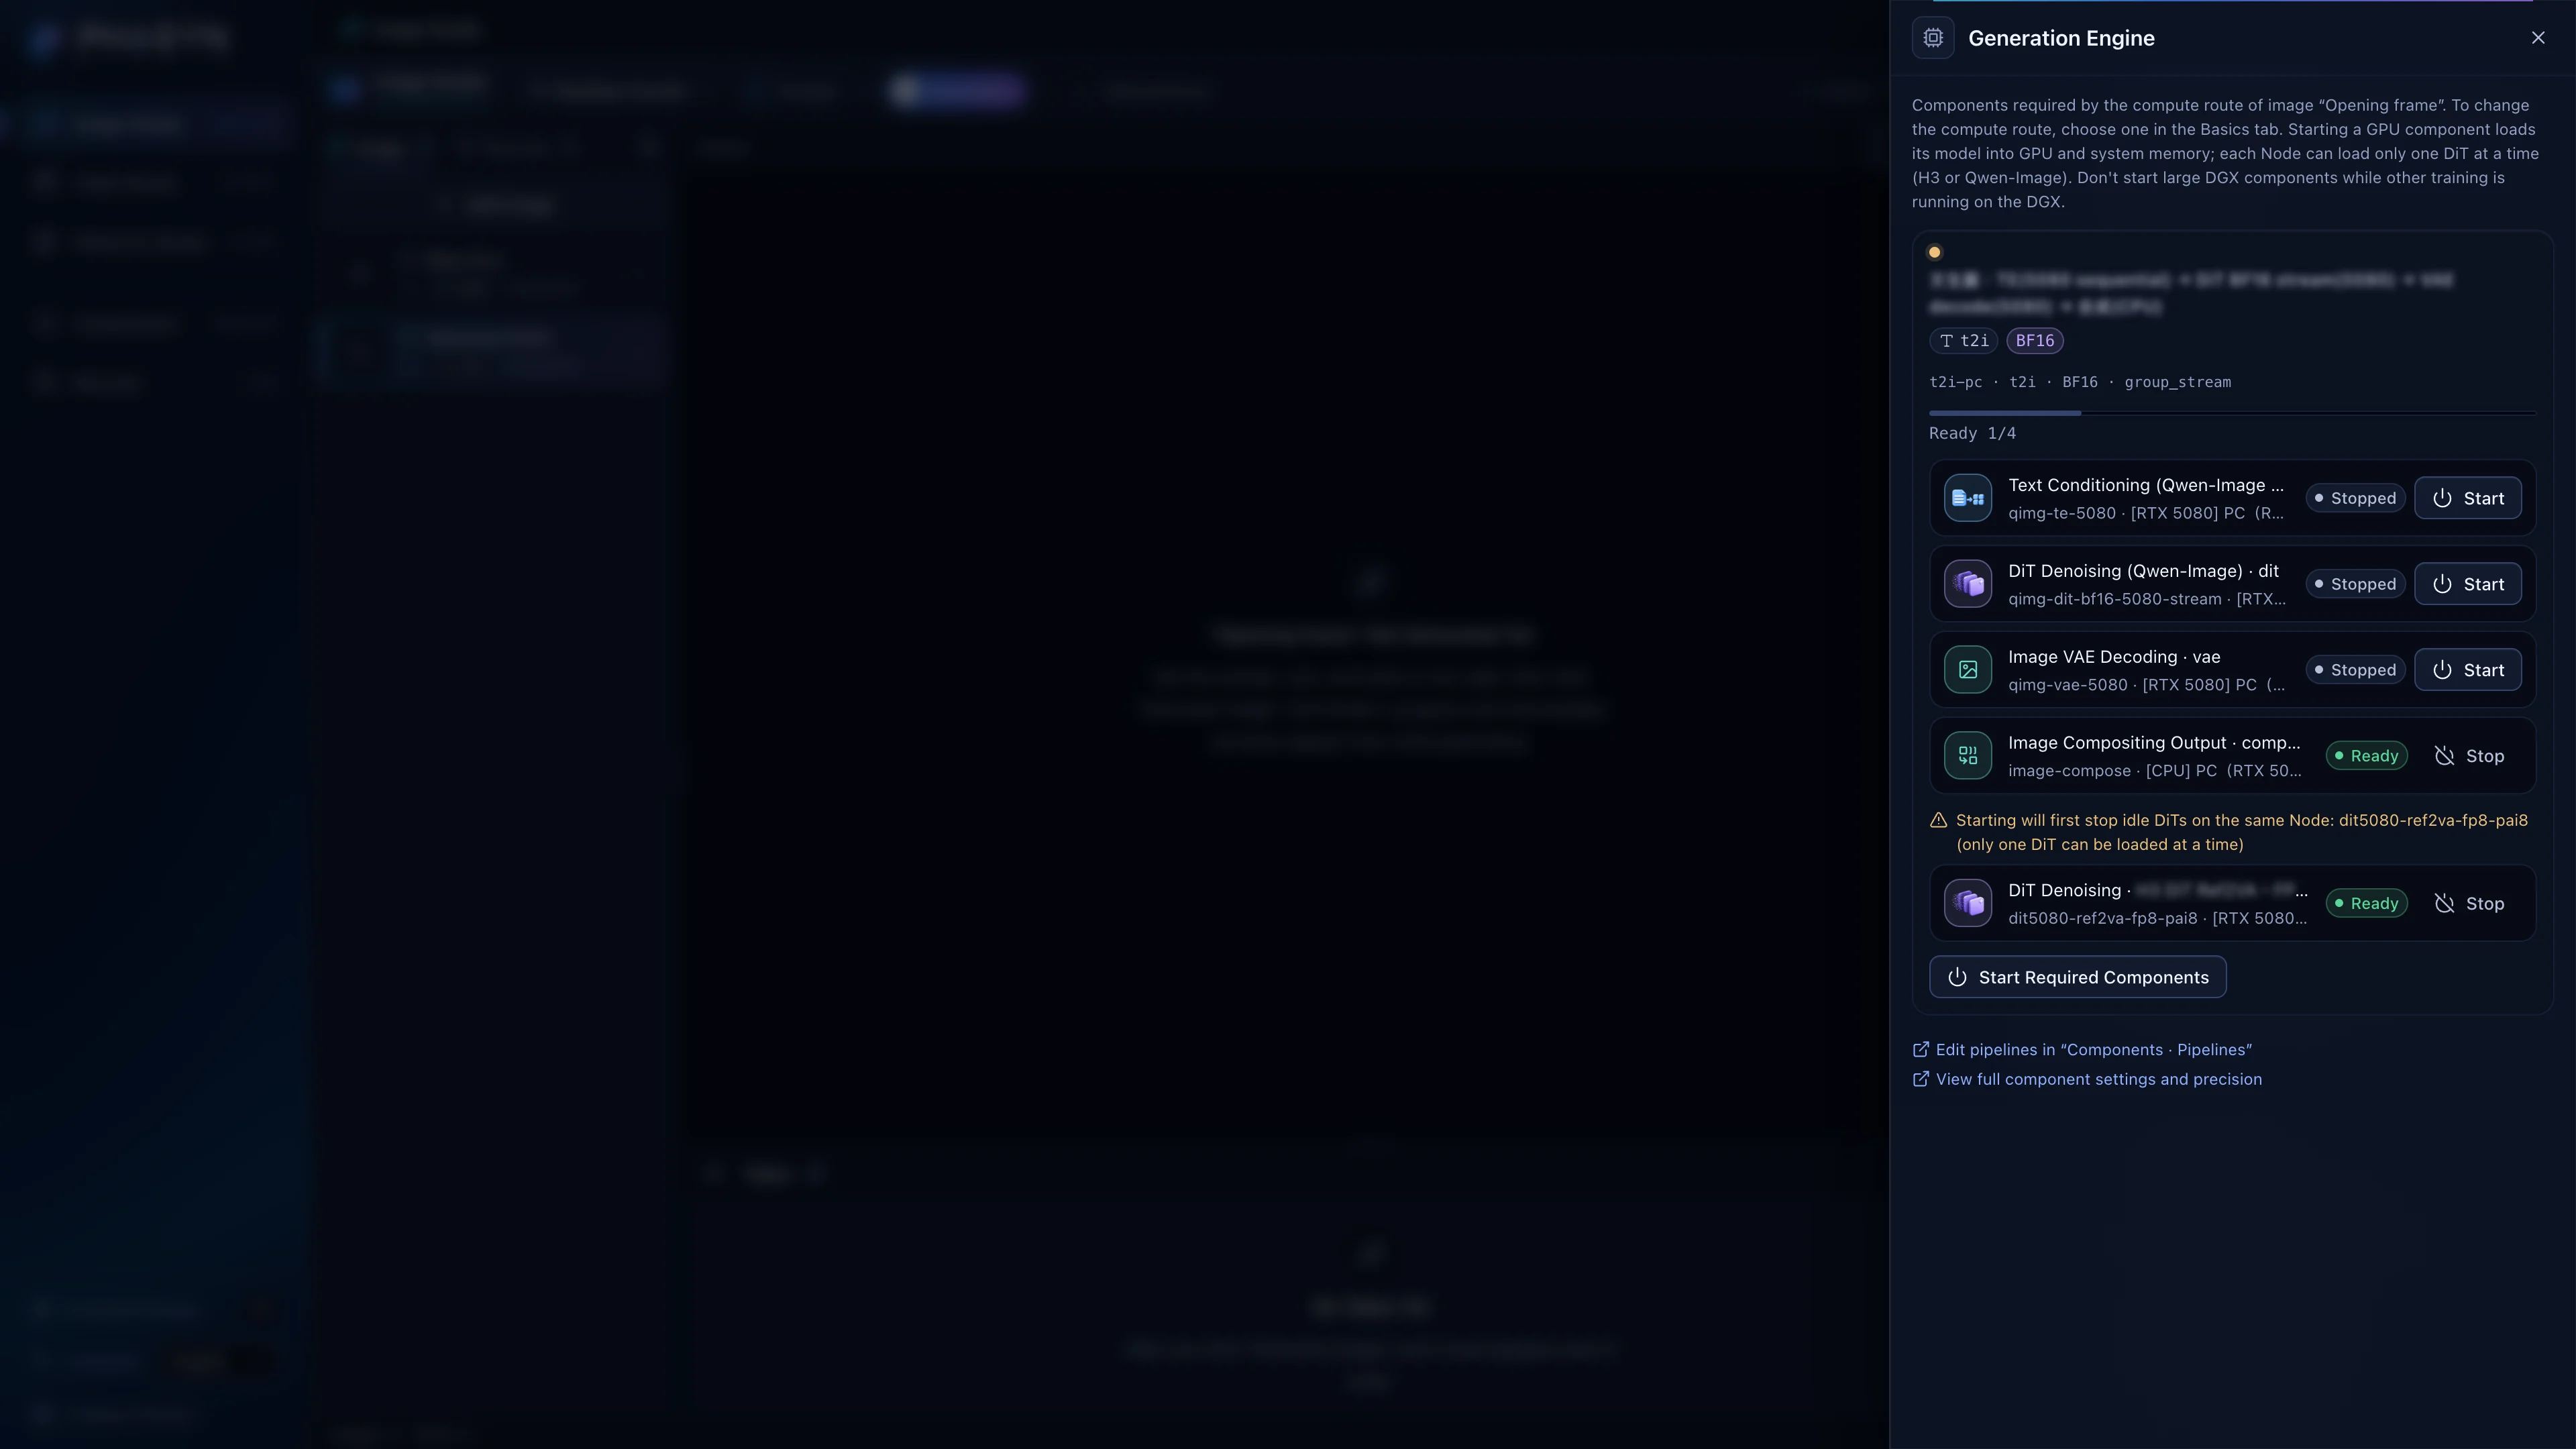
每個模型元件都是一支獨立程式(process),放在你指定的機器上。Recorder 記下每一步的時間;沒量到的就寫「Not measured」,絕不填 0。
一個元件,一支程式
文字編碼、DiT、VAE 與封裝(mux)各自執行,精度與卸載可以逐一設定。某個模型當掉,也不會拖垮整個 App。
節點之間直接傳
latent、影片這類大型中間檔以 FileRef 在機器之間直接搬,不經過 Controller;Controller 負責排程、紀錄,並提供你上傳的檔案。實測(2026-10-17 的 t2va 渲染):PC 上的 DiT 從 DGX Spark 取得 219–322 KB 的條件資料,只花 30–34 ms。
Recorder 定義 102 項指標
每項都有單位與量測方法:CPU 與 GPU 時間、VRAM、傳輸量。一次 fl2va 渲染(run cfa759df)的 7 份紀錄實際記下 82 項。2–8 份紀錄可以並排比較,也能匯出 JSONL、CSV、ZIP 或 trace。
也為 Agent 而做。
內附的 Agent Skill 提供 phasynctl 命令列工具,以及可選用的 MCP 伺服器(22 個工具)。
phasyn_doctor · phasyn_run_create · phasyn_runs_compare · phasyn_recordings_compare …
phasynctl runs create --dry-run 會在上傳任何東西之前,先用即時的 schema 檢查每一個參數。
用 phasynctl runs create / wait / download 寫腳本,就能批次送出、等完成、下載結果;Video Studio 也有 Batch Render。
實驗 06 用 Studio 介面跑一次、用 MCP 跑一次,兩次輸出逐位元相同(bit-identical)。
和其他工具哪裡不一樣
- 節點式工作流程工具通常在一個程序裡執行整張圖;Phasyn Studio 讓每個模型元件(文字編碼、DiT、VAE、封裝)各自是一支獨立程式,所以當掉不會擴散,一次渲染也能橫跨多台機器。
- 多後端的前端是把整個工作分派到不同機器;Phasyn Studio 拆的是同一次渲染:文字編碼在 DGX Spark,DiT 在 RTX 5080,音訊在 RTX 3060。
- 雲端服務目前解析度更高;Phasyn Studio 跑在你自己的硬體上,不用點數,而且記下每一秒花在哪裡。
目前的執行環境:RTX 50 系列、RTX 30 系列、DGX Spark(GB10);RTX 40 系列(例如 4090)還沒有對應的執行環境。
多機的用途是把同一次渲染的各個元件分到不同 GPU;目前一次執行一個 run,不是多支影片平行運算。
展開工程細節:架構圖與實際畫面
實測、公開,連失敗也列出來。
40 個 H3 DiT 變體,在同一張 RTX 5080 上計時:37 個跑完,3 個 NF4 變體沒能載入,它們也在表格裡。
- 一段 5.17 秒有聲影片
- 57–76s
- fl2va · 2026-10-18 實測 4 次 · 文字 DGX Spark · DiT 與影片 RTX 5080 · 音訊 RTX 3060
- 最快的 DiT 階段(冷載入後第一次呼叫)
- 33.2s
- 其中去噪運算 26.0 s · INT8 · PAI 8 步 · RTX 5080
- 跑完的 DiT 變體
- 37/40
- 同一張 RTX 5080,共 3.2 小時 · 3 個 NF4 變體載入失敗,照實列為失敗
每個速度數字,都寫明每一步在哪台機器上跑;舊實驗封存裡沒記錄的,直接標「未記錄裝置」。
找出適合你硬體的跑法還沒推出的,直接說清楚。
測試中、即將加入、設計目標,每一項都標好狀態。開發順序以我自己的需求為主。
- 測試中
一鍵換角
五步精靈已經做好,還沒跑過完整影片。請只使用你有權使用的素材,不要冒用真人身分。
- 已實作・未驗證
影片反推提示詞
程式已經寫好,還沒用真正的模型驗證過。
- 即將加入
去背
在 Image Studio 裡直接去背。
- 設計目標
租一台機器,用一兩個小時
部署、啟動、處理、匯出、關機,用完就關。還沒打包成現成流程。
- 開發中
多層級渲染 · TTS 與聲音轉換 · 超解析與補幀
先用簡單畫面快速定鏡頭,再套入人物、出成片;自己開發的 TTS 系統;幾種超解析與補幀技術正在整合。
- 規劃中
生成外掛與滑桿 · 擴充模型支援 · VAE 與 DiT 最佳化
用滑桿與 LoRA 風格做更細的控制;串接第三方模型,例如 Suno 的音樂;影片 VAE 的編碼與解碼負擔仍然太重。
另外也參考了 ArtCraft 的相關功能,目前還沒有整合。
追蹤進度現在能用嗎?
- 下載
- 還不行。目前沒有下載、沒有安裝程式,也不用註冊或付費。原始碼整理好後以 Apache-2.0 公開。
- 電腦
- 需要 NVIDIA 顯示卡。執行環境目前只支援 RTX 50 系列、RTX 30 系列與 DGX Spark(GB10);RTX 40 系列與 Mac 都還不支援。用參考素材生成影片時,16 GB 顯示卡已經很勉強(實測整卡峰值 15.91 GiB)。
- 費用
- 原始碼公開後免費(Apache-2.0);模型權重不隨專案提供,需自行取得並遵守各自授權。
- 能不能商用
- Qwen‑Image 2.1 只能用於研究與非商業用途;MiniMax H3 的授權地區不含歐盟、英國、韓國與美國,並有使用規範。有營利的頻道、業配或接案,請先確認授權。
- 想第一時間知道
- 在 GitHub 或 Hugging Face 追蹤 phasyn,或寫信到 [email protected]。
Phasyn Studio 是一個框架:不隨附、也不散布任何模型權重;你自備模型,並依各自的授權使用。
讓你的想法動起來。
原始碼與架構說明即將公開。在 GitHub 追蹤 phasyn,發佈時第一時間知道;新的影片素材放在 Hugging Face;有想法也歡迎直接寫信。
即將開放原始碼與架構說明關於這個專案