メインコンテンツへスキップ

BENCHMARKS · RTX 5080 · DGX SPARK · RTX 3060

一秒も、うやむやにしない。

MiniMax H3 と Qwen-Image 2.1 を、作者の 2 台のマシン、3 つの GPU(同じ PC の RTX 5080 と RTX 3060、そして DGX Spark)で実際に動かした記録です。各ステップをどのデバイスで実行したかを明記しています。表を参考に、お使いのハードウェアに合う構成を選んでください。うまくいかなかった実行も、そのまま載せています。

  • 先頭フレームから動画 fl2va

    57.2–76.0 s

    5.17 秒・768×448・124 フレーム、音声付き

    10/18 に 4 回計測・エンドツーエンド

    76 s は 10/18 最初の fl2va run です(先頭フレームのエンコード 6.1 s、音声デコード 5.8 s。その後の 3 回は約 1 s)。DiT と映像デコードも遅めでした。

    • DGX Spark (GB10)
    • RTX 5080
    • RTX 3060
    • PC の CPU
  • 参照画像から動画 ref2va

    105.0–108.0 s

    参照画像 1 枚、同じ出力仕様

    10/18 に 2 回計測・エンドツーエンド

    • DGX Spark (GB10)
    • RTX 5080
    • RTX 3060
    • PC の CPU
  • Qwen-Image 2.1 の静止画

    25.8–26.9 s

    1152×672・40 ステップ

    10/18 に 4 回計測・エンドツーエンド

    • RTX 5080
    • PC の CPU

1 回のレンダリングに 3 つの GPU

ref2va · run 5adf4237 · 10/18 計測

  1. 1

    テキストエンコード

    • te-gb108.3 s
  2. 2

    参照・先頭フレームのエンコード

    • venc-50805.5 s
    • aenc-30601.5 s
  3. 3

    DiT ノイズ除去

    • dit5080-ref2va-fp8-pai868.0 s
  4. 4

    映像と音声のデコード

    • vae-508022.5 s
    • audio-30600.9 s
  5. 5

    多重化

    • mux0.3 s
  • RTX 508016 GB(Recorder 上のカード全体 15.92 GiB)
  • DGX Spark (GB10)128 GB のユニファイドメモリ(CPU と GPU で共有)
  • RTX 306012 GB
  • PC の CPUメインメモリ 62.6 GiB(RTX 5080 へストリーミングする pinned の重みも保持)

2026-10-17 の初期の run では参照エンコードを RTX 3060 で実行し、その後 RTX 5080 に移しました(約 3.4 倍高速)。

  • fl2va · テキストエンコード · te-gb101.4 s
  • fl2va · 先頭フレームのエンコード · venc-50801.0 s
  • fl2va · DiT · dit-508031.7 s
  • fl2va · 映像デコード · vae-508022.8 s
  • fl2va · 音声デコード · audio-30600.9 s
  • fl2va · 多重化 · mux0.3 s
  • ref2va · テキストエンコード(参照画像あり) · te-gb108.3 s
  • ref2va · DiT(参照画像 1 枚) · dit5080-ref2va-fp8-pai868.0 s
  • t2i · Qwen-Image DiT · qimg-dit-bf16-5080-stream≈23.5 s

6 つの結論

まずこの 6 点を見てから、速度表でご自身の構成を探してください。

  1. 6.0–6.4×

    オリジナル 50 ÷ PAI 8

    精度より高速化方式

    PAI 8 はオリジナル 50 ステップより 6.0–6.4 倍速く、同じ高速化なら INT8 は FP8 より 3.6–10.2% 速いだけです(ノイズ除去の計算時間。いずれもコールドの単発・seed 1 つなので、小さな差は目安です)。

    データを見る
  2. 600.5 → 297.2 s

    1 セグメントの合計

    コストは参照素材、448 で半分

    差し替えの run では参照動画が DiT シーケンスの 47% を占めます。参照動画を 448 に前処理すると、1 セグメントが 600.5 s から 297.2 s になりました。

    データを見る
  3. 15.91 / 15.92 GiB

    カード全体の NVML ピーク

    16 GB に収まる、ただしぎりぎり

    参照ありでは DiT が最大 13.6 GiB を確保し、カード全体のピークは 15.92 GiB 中 15.91 GiB です。余裕 1.6 GiB は安全、0.8 GiB は不十分でした。

    データを見る
  4. 3.4×

    参照動画のエンコード:RTX 5080 対 RTX 3060

    エンコーダーは、それぞれ合う場所へ

    全精度の Qwen3-VL テキストエンコーダー(te-gb10)は DGX Spark に置いたままです。常駐で約 52 GB、呼び出し中は最大約 60 GB で、DiT と同居する 16 GB のカードにはとても収まりません。参照動画のエンコードは RTX 3060 から RTX 5080 に移し、248–250 s が 72–74 s になりました。

    データを見る
  5. 4 / 4

    衣装が漏れた seed

    Turbo 4 は速いが、元の衣装が残る

    差し替えの条件(参照動画 768、キャラクター 2 人)では、Turbo 4 の DiT は 229–236 s(PAI 8 は 466–473 s)ですが、4 つの seed すべてで元のキャラクターの衣装が出力に残りました。そのため本番の ref2va は PAI 8 のままです。

    データを見る
  6. 16

    失敗・取り消しの run

    失敗もそのまま載せる

    NF4 の DiT 3 種の読み込み失敗、8 ステップで送った Turbo 4 の拒否、参照動画 768 で 3 人を入れた OOM、BF16 phase の画像生成の事前チェック拒否。すべて表にあります。

    データを見る

速度表

1 行が 1 回の実際の実行です。パイプライン、DiT バリアント、出力、各ステップの時間とデバイス、DiT 時間、エンドツーエンドの合計、VRAM を並べています。最初は主要な行を表示し、すべてのデータを読み込むと全行を並べ替え・絞り込みできます。

全 77 行のうち主要な 32 行 ·

速度表
Runパイプラインと入力DiT バリアントステップとデバイスs?実時間 / ノイズ除去s?GiB?allocated / reservedカード全体状態
fl2va

先頭フレーム:同じ日に生成した Qwen-Image の静止画

FP8 · PAI 8768×448 · 124 フレームdit-5080
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
38.776.0記録なし成功
fl2va

先頭フレーム:同じ日に生成した Qwen-Image の静止画

FP8 · PAI 8768×448 · 124 フレームdit-5080
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
32.057.2記録なし成功
fl2va

先頭フレーム:同じ日に生成した Qwen-Image の静止画

FP8 · PAI 8768×448 · 124 フレームdit-5080
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
31.757.4記録なし成功
fl2va

先頭フレーム:同じ日に生成した Qwen-Image の静止画

FP8 · PAI 8768×448 · 124 フレームdit-5080
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
33.258.6記録なし成功
ref2va

参照画像 1 枚:同じ日に生成したキャラクターシート

FP8 · PAI 8768×448 · 124 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
70.0108.0記録なし成功
ref2va

参照画像 1 枚:同じ日に生成したキャラクターシート

FP8 · PAI 8768×448 · 124 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
68.0105.0記録なし成功
t2va

テキストプロンプトのみ

FP8 · PAI 8768×448 · 124 フレームdit-5080
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
37.8ノイズ除去28.9通し計測ではないrun 64.0 s3.66 / 4.93カード全体 7.22成功
t2va

テキストプロンプトのみ

INT8 · PAI 8768×448 · 124 フレームdit5080-fl2va-int8-pai8
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
33.2ノイズ除去26.0通し計測ではないrun 60.2 s3.65 / 4.93カード全体 7.22成功
t2va

テキストプロンプトのみ

BF16 · PAI 8768×448 · 124 フレームdit5080-fl2va-bf16-pai8
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
65.2ノイズ除去58.5通し計測ではないrun 91.7 s4.67 / 6.37カード全体 8.66成功
t2va

テキストプロンプトのみ

FP8 · Turbo 4768×448 · 124 フレームdit5080-fl2va-fp8-lx4
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
44.6ノイズ除去33.5通し計測ではないrun 73.4 s6.18 / 7.32カード全体 9.63成功
t2va

テキストプロンプトのみ

INT8 · Turbo 4768×448 · 124 フレームdit5080-fl2va-int8-lx4
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
40.6ノイズ除去31.5通し計測ではないrun 67.8 s6.17 / 7.31カード全体 9.61成功
t2va

テキストプロンプトのみ

FP8 · Turbo 8768×448 · 124 フレームdit5080-fl2va-fp8-lx8
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
57.8ノイズ除去48.4通し計測ではないrun 85.0 s6.18 / 7.32カード全体 9.63成功
t2va

テキストプロンプトのみ

INT8 · オリジナル 50 ステップ768×448 · 124 フレームdit5080-fl2va-int8-base
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
174.5ノイズ除去166.6通し計測ではないrun 201.7 s4.88 / 5.96カード全体 8.27成功
t2va

テキストプロンプトのみ

BF16 · オリジナル 50 ステップ768×448 · 124 フレームdit5080-fl2va-bf16-base-exact公式精度
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
413.5ノイズ除去407.8通し計測ではないrun 440.1 s6.31 / 8.93カード全体 11.24成功
ref2va

キャラクター参照画像 2 枚(透過 PNG)

FP8 · PAI 8768×448 · 124 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
120.9ノイズ除去115.5通し計測ではないrun 144.2 s6.43 / 10.13カード全体 12.42成功
ref2va

キャラクター参照画像 2 枚(透過 PNG)

INT8 · PAI 8768×448 · 124 フレームdit5080-ref2va-int8-pai8
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
119.4ノイズ除去110.3通し計測ではないrun 146.7 s6.43 / 10.09カード全体 12.37成功
ref2va

キャラクター参照画像 2 枚(透過 PNG)

FP8 · Turbo 4768×448 · 124 フレームdit5080-ref2va-fp8-lx4
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
91.1ノイズ除去78.6通し計測ではないrun 118.2 s8.52 / 12.27カード全体 14.58成功
ref2va

キャラクター参照画像 2 枚(透過 PNG)

INT8 · Turbo 4768×448 · 124 フレームdit5080-ref2va-int8-lx4
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
83.9ノイズ除去74.4通し計測ではないrun 111.6 s8.51 / 12.22カード全体 14.53成功
ref2va

キャラクター参照画像 2 枚(透過 PNG)

NF4 · Turbo 4768×448 · 124 フレームdit5080-ref2va-nf4-lx4AdaLN off
RTX 5080
——未計測読み込み失敗
ref2va

キャラクター参照画像 2 枚(透過 PNG)

INT8 · Turbo 8768×448 · 124 フレームdit5080-ref2va-int8-lx8
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
140.7ノイズ除去130.0通し計測ではないrun 167.6 s8.51 / 12.22カード全体 14.53成功
ref2va

キャラクター参照画像 2 枚(透過 PNG)

INT8 · オリジナル 50 ステップ768×448 · 124 フレームdit5080-ref2va-int8-base
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
682.9ノイズ除去672.3通し計測ではないrun 709.9 s7.22 / 10.86カード全体 13.16成功
ref2va

キャラクター参照画像 2 枚(透過 PNG)

BF16 · オリジナル 50 ステップ768×448 · 124 フレームdit5080-ref2va-bf16-base-exact公式精度
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
1,515.5ノイズ除去1,507.3通し計測ではないrun 1,543.0 s8.37 / 13.06カード全体 15.37成功
ref2va

キャラクター画像 2 枚+5.17 秒の参照動画(音声付き)

FP8 · PAI 8768×448 · 124 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
470.7ノイズ除去464.3600.511.15 / 12.54カード全体 15.70成功
ref2va

キャラクター画像 2 枚+5.17 秒の参照動画(音声付き)

INT8 · Turbo 4768×448 · 124 フレームdit5080-ref2va-int8-lx4
DGX Spark (GB10)RTX 3060RTX 5080
——11.60 / 13.61カード全体 14.86GPU メモリ不足
ref2va

R5 の条件エンコードを再利用

INT8 · Turbo 4768×448 · 124 フレームdit5080-ref2va-int8-lx4-fixedAdaLN fixed
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
229.3ノイズ除去227.1通し計測ではないrun 256.8 s11.37 / 12.76カード全体 15.91成功
ref2va

キャラクター画像 2 枚+5.88 秒の動画

FP8 · PAI 8768×448 · 141 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 5080RTX 3060
——11.83 / 12.58カード全体 15.54GPU メモリ不足
ref2va

キャラクター画像 2 枚+5.88 秒の動画

INT8 · Turbo 4768×448 · 141 フレームdit5080-ref2va-int8-lx4-fixedAdaLN fixed
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
269.9ノイズ除去266.5407.112.07 / 12.60カード全体 15.76成功
ref2va

キャラクター画像 2 枚+5.17 秒の動画、参照動画 448

FP8 · PAI 8768×448 · 124 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
223.9ノイズ除去220.3297.28.24 / 10.40カード全体 12.85成功
ref2va

キャラクター画像 2 枚+6.58 秒の動画、参照動画 448

FP8 · PAI 8768×448 · 158 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 5080RTX 3060PC の CPU
282.3ノイズ除去278.4365.79.01 / 11.25カード全体 14.41成功
ref2va

キャラクター参照画像 2 枚(透過 PNG)

FP8 · PAI 8768×448 · 124 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
117.2ノイズ除去114.6186.16.43 / 10.13カード全体 12.37成功
ref2va

参照画像 1 枚+参照動画(音声付き)

FP8 · PAI 8768×448 · 124 フレームdit5080-ref2va-fp8-pai8
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
293.6ノイズ除去290.7541.39.15 / 11.31カード全体 13.60成功
fl2va

先頭フレーム画像 1 枚

FP8 · PAI 8768×448 · 124 フレームdit-5080
DGX Spark (GB10)RTX 3060RTX 5080PC の CPU
39.068.3未計測成功

時間は秒、VRAM は GiB(2^30 バイト)です。同時に実行するステップ(映像と音声のデコード、参照映像と音声のエンコード)は重なるため、ステップの合計は全体の時間を超えます。

画像:Qwen-Image 2.1

画像パイプラインはステップも単位も異なるため、別の表にしています。GPU のステップはすべて RTX 5080、合成は CPU です。

全 23 行のうち主要な 6 行 ·

画像:Qwen-Image 2.1
Runパイプラインと入力DiT バリアントステップとデバイスs?実時間 / ノイズ除去s?GiB?allocated / reservedカード全体状態
t2i

テキストプロンプト(オリジナルキャラクター)

BF16 · 40 ステップ1152×672qimg-dit-bf16-5080-streamstream
RTX 5080PC の CPU
≈23.026.0記録なし成功
t2i

テキストプロンプト(オリジナルキャラクター)

BF16 · 40 ステップ1152×672qimg-dit-bf16-5080-streamstream
RTX 5080PC の CPU
≈23.026.9記録なし成功
t2i

テキストプロンプト(オリジナルキャラクター)

BF16 · 40 ステップ1152×672qimg-dit-bf16-5080-streamstream
RTX 5080PC の CPU
≈23.025.9記録なし成功
t2i

テキストプロンプト(オリジナルキャラクター)

BF16 · 40 ステップ1152×672qimg-dit-bf16-5080-streamstream
RTX 5080PC の CPU
≈23.025.8記録なし成功
t2i

テキストプロンプト(陶器のカップ)

GGUF Q4_K_M · 40 ステップ1024×1024qimg-dit-gguf-5080gguf
RTX 5080PC の CPU
38.641.25.07 / 5.59カード全体 —成功
t2i

テキストプロンプト(陶器のカップ)

BF16 · 40 ステップ1024×1024qimg-dit-bf16-5080-streamstream
RTX 5080PC の CPU
33.047.91.56 / 5.88カード全体 9.19成功

失敗も、そのまま

失敗または取り消しになった run です。失敗するまでにかかった時間も載せています。

Run内容エラーコード失敗したステップ停止まで
実験 01読み込み失敗ref2va · NF4 · Turbo 4dit5080-ref2va-nf4-lx4キャラクター参照画像 2 枚(透過 PNG)RUNTIME_ERRORDiT の読み込みRTX 5080未実行
実験 02 · 9d7d9e6f · R3bGPU メモリ不足ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx4キャラクター画像 2 枚+5.17 秒の参照動画(音声付き)GPU_OOMDiT ノイズ除去RTX 5080323.9 s
実験 05 · 58da16b6GPU メモリ不足ref2va · FP8 · PAI 8dit5080-ref2va-fp8-pai8キャラクター画像 2 枚+5.88 秒の動画GPU_OOMDiT ノイズ除去RTX 5080118.0 s
実験 01読み込み失敗ref2va · NF4 · Turbo 8dit5080-ref2va-nf4-lx8キャラクター参照画像 2 枚(透過 PNG)RUNTIME_ERRORDiT の読み込みRTX 5080未実行
実験 01読み込み失敗ref2va · NF4 · オリジナル 50 ステップdit5080-ref2va-nf4-baseキャラクター参照画像 2 枚(透過 PNG)RUNTIME_ERRORDiT の読み込みRTX 5080未実行
実験 02 · 7fa18f97 · R3不正な設定ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx4キャラクター画像 2 枚+5.17 秒の参照動画(音声付き)INVALID_ARGUMENTDiT ノイズ除去RTX 5080287.3 s
実験 02 · 9597890a · R6不正な設定ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx4キャラクター画像 2 枚+5.17 秒の参照動画(音声付き)INVALID_ARGUMENTDiT ノイズ除去RTX 5080281.4 s
実験 02 · 07156692 · R6b取り消しref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx4キャラクター画像 2 枚+5.17 秒の参照動画(音声付き)CANCELLED参照エンコード(映像 VAE)RTX 3060201.1 s
実験 05 · f612bb72GPU メモリ不足ref2va · FP8 · PAI 8dit5080-ref2va-fp8-pai8キャラクター画像 3 枚(3 枚目は複製)+5.17 秒の動画GPU_OOMDiT ノイズ除去RTX 5080131.7 s
実験 05 · 3ae8e653GPU メモリ不足ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx4-fixedキャラクター画像 3 枚(3 枚目は複製)+5.17 秒の動画GPU_OOMDiT ノイズ除去RTX 5080133.5 s
実験 09 · dc6453d1 · E1不正な設定ref2va · FP8 · PAI 8dit5080-ref2va-fp8-pai8キャラクター参照画像 2 枚(透過 PNG)INVALID_ARGUMENT映像デコードRTX 5080236.8 s
実験 12 · f16484ff事前チェックで拒否t2i · BF16 · 40 ステップqimg-dit-bf16-5080-phaseテキストプロンプト(陶器のカップ)422DiT ノイズ除去RTX 508014.4 s
実験 12 · 03261cb0GPU メモリ不足t2i · BF16 · 40 ステップqimg-dit-bf16-5080-streamテキストプロンプト(陶器のカップ)GPU_OOMVAE デコードRTX 508043.5 s
実験 12 · 5c0a3c90事前チェックで拒否i2i · BF16 · 40 ステップqimg-dit-bf16-5080-streamテキストプロンプト+参照画像422VAE デコードRTX 508049.7 s
実験 12 · 947ed5ba事前チェックで拒否i2i · GGUF Q4_K_M · 40 ステップqimg-dit-gguf-5080テキストプロンプト+参照画像422DiT ノイズ除去RTX 5080未実行
実験 12 · 3e8b52deGPU メモリ不足i2i · BF16 · 4 ステップqimg-dit-bf16-5080-streamテキストプロンプト+参照画像GPU_OOMVAE デコードRTX 508020.1 s

データをダウンロード

表と同じデータで、ホスト名やファイルパスは含みません。秒数は計算時間と書かれた列以外は実時間、VRAM は GiB です。

10 月 18 日の計測

6 本の動画と 4 枚の静止画は、10 月 18 日にオリジナルキャラクター The Courier を使い、コントローラー API の本番ルート(t2i-pc・fl2va-pc・ref2va-pc)で生成しました。各 1 回の実行で、時間はコントローラーが記録したステップ時間です。

10/18 計測各 1 回Web 版はラウドネスを正規化しています(元の出力は約 −37〜−50 LUFS、AAC 32 kHz)。

AI 生成 · Powered by MiniMax H3

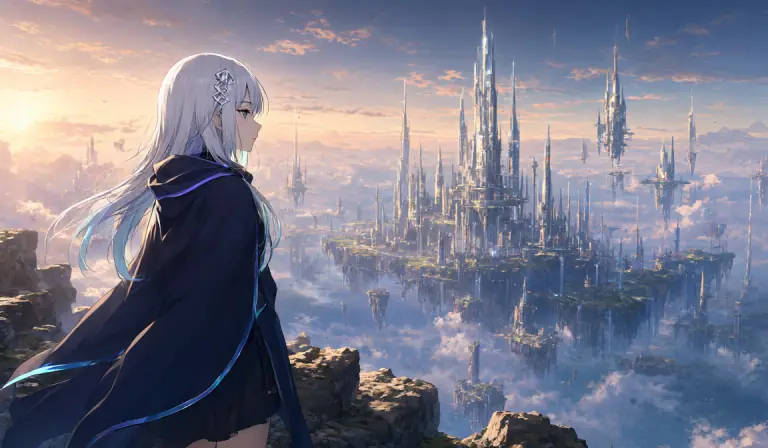
夜明けの崖

76.0 sエンドツーエンド

fl2varun 82d036a7dit-5080Seed 101

  • テキストエンコード· DGX Spark (GB10)2.3 s
  • 先頭フレームのエンコード(映像 VAE)· RTX 50806.1 s
  • DiT ノイズ除去· RTX 508038.7 s
  • 映像デコード· RTX 508027.7 s
  • 音声デコード· RTX 30605.8 s
  • 多重化· PC の CPU0.5 s

音声(H3 が生成):高所の強い風、マントがはためく音、遠くの滝の音
AI 生成 · Powered by MiniMax H3

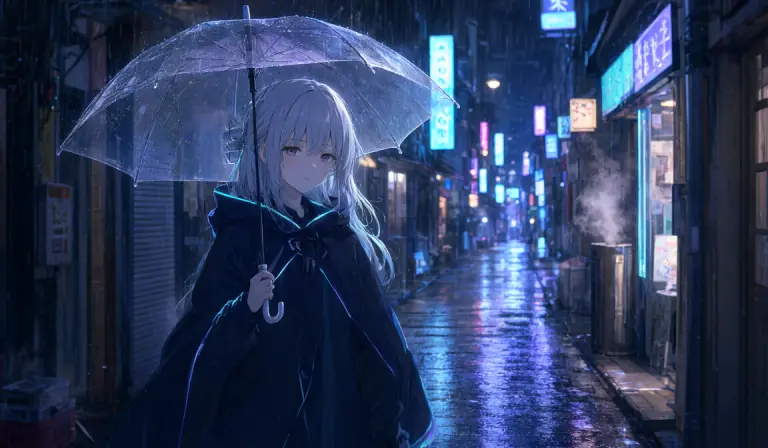
ネオンの雨

57.2 sエンドツーエンド

fl2varun cfa759dfdit-5080Seed 202

  • テキストエンコード· DGX Spark (GB10)1.3 s
  • 先頭フレームのエンコード(映像 VAE)· RTX 50801.1 s
  • DiT ノイズ除去· RTX 508032.0 s
  • 映像デコード· RTX 508022.4 s
  • 音声デコード· RTX 30600.9 s
  • 多重化· PC の CPU0.3 s

音声(H3 が生成):激しい雨音、軒先の雫、水たまりを踏む足音、ネオンのかすかな唸り

AI 生成 · Powered by MiniMax H3

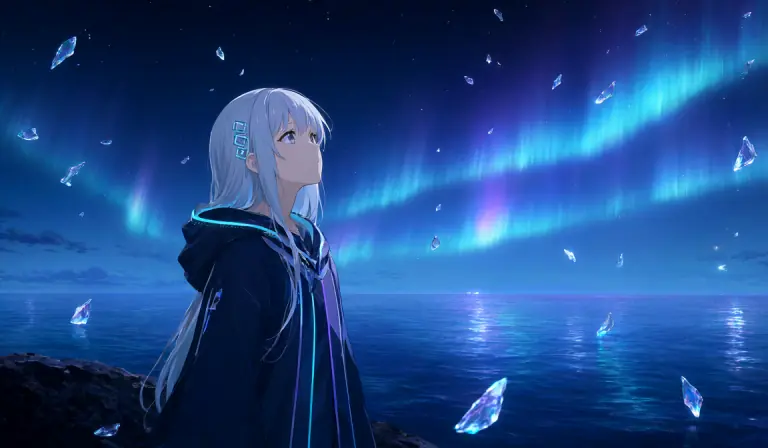
オーロラの海

57.4 sエンドツーエンド

fl2varun 72341805dit-5080Seed 303

  • テキストエンコード· DGX Spark (GB10)1.4 s
  • 先頭フレームのエンコード(映像 VAE)· RTX 50801.0 s
  • DiT ノイズ除去· RTX 508031.7 s
  • 映像デコード· RTX 508022.8 s
  • 音声デコード· RTX 30600.9 s
  • 多重化· PC の CPU0.3 s

音声(H3 が生成):岩に寄せる波、そよ風、ガラス片の澄んだ響き

AI 生成 · Powered by MiniMax H3

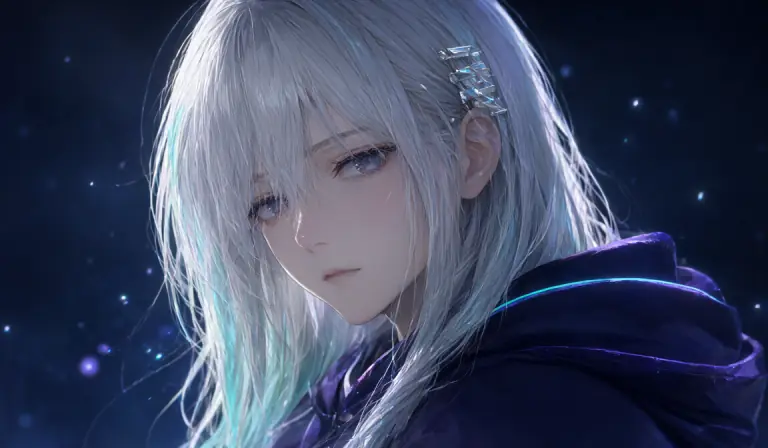
クローズアップ

58.6 sエンドツーエンド

fl2varun 7d52714adit-5080Seed 404

  • テキストエンコード· DGX Spark (GB10)1.3 s
  • 先頭フレームのエンコード(映像 VAE)· RTX 50801.0 s
  • DiT ノイズ除去· RTX 508033.2 s
  • 映像デコード· RTX 508022.5 s
  • 音声デコード· RTX 30600.7 s
  • 多重化· PC の CPU0.4 s

音声(H3 が生成):かすかな空気の音、光の粒が漂う繊細な音、彼女の息づかい

AI 生成 · Powered by MiniMax H3

屋上の跳躍

108.0 sエンドツーエンド

ref2varun f083d166dit5080-ref2va-fp8-pai8Seed 505

  • テキストエンコード· DGX Spark (GB10)8.5 s
  • 参照エンコード(映像 VAE)· RTX 50805.7 s
  • 参照音声のエンコード· RTX 30601.7 s
  • DiT ノイズ除去· RTX 508070.0 s
  • 映像デコード· RTX 508022.8 s
  • 音声デコード· RTX 30601.0 s
  • 多重化· PC の CPU0.5 s

音声(H3 が生成):吹き抜ける風、コンクリートを駆ける足音、マントのはためき、着地音、飛び立つ鳥

AI 生成 · Powered by MiniMax H3

丘の草原

105.0 sエンドツーエンド

ref2varun 5adf4237dit5080-ref2va-fp8-pai8Seed 606

  • テキストエンコード· DGX Spark (GB10)8.3 s
  • 参照エンコード(映像 VAE)· RTX 50805.5 s
  • 参照音声のエンコード· RTX 30601.5 s
  • DiT ノイズ除去· RTX 508068.0 s
  • 映像デコード· RTX 508022.5 s
  • 音声デコード· RTX 30600.9 s
  • 多重化· PC の CPU0.3 s

音声(H3 が生成):暖かいそよ風、波打つ草の音、遠くの鳥の声、ガラスの枠が指先に触れる澄んだ音

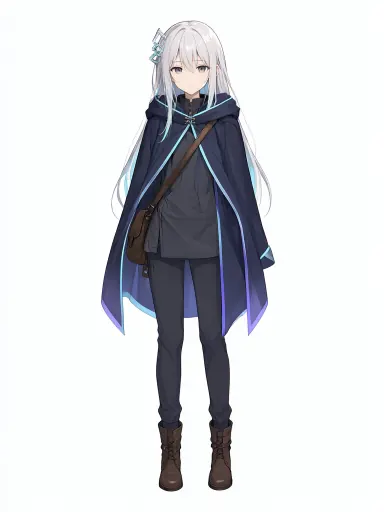
AI 生成 · Qwen-Image 2.1ref2va の参照画像
ref2va の参照画像キャラクターシート自体も、同じ日に Qwen-Image 2.1(t2i-pc)で生成しました。1 回 26.0–26.1 s、テキストエンコーダーがコールドのときは 36.6 s です。

Qwen-Image 2.1 の静止画

AI 生成 · Qwen-Image 2.1

1152×672・40 ステップ。テキストエンコード、DiT、VAE は RTX 5080、合成は CPU です。これらの静止画は fl2va の先頭フレームにも使いました。

  • 夜明けの崖夜明けの崖26.0 srun 3a6d932d
  • ネオンの雨ネオンの雨26.9 srun 0e2463b8
  • オーロラの海オーロラの海25.9 srun d47c0fa1
  • クローズアップクローズアップ25.8 srun 577fc7a4

DiT 40 種を、1 枚の RTX 5080 で

同じテキスト条件・同じ参照 latent・同じ seed で、DiT コンポーネントだけを入れ替えました。DiT コンポーネント 40 種を計測し、37 種が動画を出力、NF4 の 3 種は読み込みに失敗しました。読み込めた DiT はすべて RTX 5080 のレイヤーストリーミングで実行しています。

要点

  • 速度はまず高速化方式、次に量子化で決まります。同じ高速化なら INT8 は FP8 より 3.6–10.2% 速く、BF16 は 1.6–2.0 倍遅く、オリジナル 50 ステップは PAI 8 より 6.0–6.4 倍遅くなります(ノイズ除去の計算時間)。
  • テキストのみの最速は INT8・PAI 8(DiT 33.2 s、ノイズ除去 26.0 s)で、本番の dit-5080(FP8・PAI 8)は 37.8 s/28.9 s です。参照ありの最速は INT8・Turbo 4(83.9 s/74.4 s)、本番の FP8・PAI 8 は 120.9 s/115.5 s です。
  • 実験 01 は 2026-10-17 に、コールドロード直後の初回呼び出しを計測しています。2026-10-18 の本番 run は読み込み済みの DiT による fl2va の呼び出しで 31.7–38.7 s(ウォームになってからは 31.7–33.2 s)、ここでの同じ dit-5080 は 37.8 s です。行の比較は同じ実験の中だけで行ってください。
  • AdaLN モードと使用後の解放(host/drop)は出力を変えません(デコード後の MD5 が一致)。ただし online の AdaLN は呼び出しごとにステップ外で 23–32 s 余分にかかります(fixed 2–8 s、off 2–3 s)。
  • 参照ありでは PAI 8 と Turbo 8 が黒背景の参照画像を画面に貼り付けました(124 フレーム中 21–22、37–43 フレーム)。Turbo 4 とオリジナルは 0 フレームです。NF4 の 3 種は、量子化重みに comfy_quant メタデータがなくローダーに拒否されました。

全バリアントを DiT 時間順に

表示形式

明るい青が本番で使う DiT です。その他は同じ RTX 5080 上の比較対象です。

  • ノイズ除去の計算 · 本番で使用
  • ノイズ除去の計算
  • DiT ステージ(実時間)
  • dit5080-fl2va-int8-pai8INT8 · PAI 8
  • dit5080-fl2va-fp8-pai8-dropFP8 · PAI 8 · drop
  • dit-5080FP8 · PAI 8 · 本番で使用
  • dit5080-fl2va-int8-lx4INT8 · Turbo 4
  • dit5080-fl2va-fp8-pai8-sdpaFP8 · PAI 8 · SDPA(厳密)
  • dit5080-fl2va-fp8-lx4FP8 · Turbo 4
  • dit5080-fl2va-int8-lx8INT8 · Turbo 8
  • dit5080-fl2va-fp8-lx8FP8 · Turbo 8
  • dit5080-fl2va-bf16-pai8BF16 · PAI 8
  • dit5080-fl2va-bf16-pai8-adalnoffBF16 · PAI 8 · SDPA(厳密) · AdaLN off
  • dit5080-fl2va-bf16-pai8-sdpaBF16 · PAI 8 · SDPA(厳密)
  • dit5080-fl2va-bf16-lx4BF16 · Turbo 4
  • dit5080-fl2va-bf16-lx4-sdpaBF16 · Turbo 4 · SDPA(厳密)
  • dit5080-fl2va-bf16-lx8BF16 · Turbo 8
  • dit5080-fl2va-int8-base-subblockINT8 · オリジナル 50 ステップ · SubBlock
  • dit5080-fl2va-int8-baseINT8 · オリジナル 50 ステップ
  • dit5080-fl2va-fp8-baseFP8 · オリジナル 50 ステップ
  • dit5080-fl2va-int8-base-sdpaINT8 · オリジナル 50 ステップ · SDPA(厳密)
  • dit5080-fl2va-fp8-base-sdpaFP8 · オリジナル 50 ステップ · SDPA(厳密)
  • dit5080-fl2va-bf16-baseBF16 · オリジナル 50 ステップ
  • dit5080-fl2va-bf16-base-exact-adalnoffBF16 · オリジナル 50 ステップ · 公式精度 · AdaLN off
  • dit5080-fl2va-bf16-base-exactBF16 · オリジナル 50 ステップ · 公式精度

濃い部分はレコーダーによるノイズ除去ループの計算時間、淡い延長は DiT ステージ全体の実時間までです(差は AdaLN の準備、入力の組み立て、解放)。数字は実時間 · 計算時間の順で、単位は秒です。各バーは、コールドロード直後の初回呼び出し(2026-10-17)です。2026-10-18 の本番 run は読み込み済みの DiT を呼ぶので 31.7–38.7 s(ウォームになってからは 31.7–33.2 s)で、この図で最速のコールド呼び出し 33.2 s より速くなることがあります。

映像の比較

4 つのタイルは同期して再生されます。ラベルはページ側で重ねており、動画自体に文字はありません。同じプロンプト、seed 42、768×448、124 フレームです。

AI 生成 · Powered by MiniMax H3
  1. ↖FP8 · PAI 8dit-508037.8 s
  2. ↗FP8 · Turbo 8dit5080-fl2va-fp8-lx857.8 s
  3. ↙FP8 · Turbo 4dit5080-fl2va-fp8-lx444.6 s
  4. ↘FP8 · オリジナル 50 ステップdit5080-fl2va-fp8-base193.3 s

音声は左上のタイルのものです(H3 が生成、セリフなし)。 Web 用にラウドネスを正規化しています。

ドラッグで比較:本番設定と公式精度

左は本番で使う dit-5080(FP8・PAI 8、DiT 37.8 s)、右は BF16 のオリジナル 50 ステップ・厳密 attention(413.5 s)です。2 本は同期して再生されます。 Web 用にラウドネスを正規化しています。

FP8・PAI 8 · 37.8 sBF16・オリジナル 50 · 413.5 s
AI 生成 · Powered by MiniMax H3

参照素材のコスト

ref2va の DiT シーケンスには、参照動画・参照画像・Qwen のビジョントークンがまとめて入ります。シーケンスが長いほど 1 ステップが遅くなり、その伸びは線形ではありません。

3 つの run のタイムライン(デバイス別の色)

表示形式

同時に実行したステップは上下に並べています。グレーの斜線はステップ間の帰属しない時間(スケジューリングと転送)です。

  • DGX Spark (GB10)
  • RTX 5080
  • RTX 3060
  • PC の CPU
  • 帰属なし(スケジューリング、転送)

参照動画 768 → 448:時間

表示形式

R5 の条件のまま、参照動画の前処理の短辺だけを 768 から 448 に変えました。出力は 768×448 のままです。

  • 768
  • 448
1 セグメントの合計
297.2600.5
DiT
223.9470.7
参照動画のエンコード
28.673.7
テキストエンコード
21.329.0
ノイズ除去 1 ステップの p50
27.557.9

DiT の torch allocated/reserved は 11.15 / 12.54 → 8.24 / 10.40 GiB、DiT シーケンスは 80,832 → 52,544 行です。

この節に映像はありません。差し替え実験の参照動画は第三者の素材のため、そこから派生した出力は公開しません。数値は公開しています。

方法と注意点

数値の測り方と読み方、そしてそれが示さないことです。

DiT ステージ(実時間)
DiT ステージ(すべてのノイズ除去ステップ)の開始から終了までの時間で、AdaLN の準備、入力の組み立て、解放を含みます。このページの既定値です。
ノイズ除去の計算
レコーダーの h3.denoise_av.compute_ms で、ノイズ除去ループだけの時間です。古い報告はこの値を引用しているため、補助の列にしています。
エンドツーエンド
run の作成から完了までの実時間です。すべてのステップを同じ run で実行した場合だけ載せ、他の run のステップを再利用した行には「通し計測ではない」と表示します。
デバイス
各ステップのデバイスは run 記録の node と resource group から取っています。アーカイブにない場合は「実行デバイス未記録」とし、推測はしません。
GiB と GB
RTX 5080 と RTX 3060 の VRAM はすべて GiB(2^30 バイト)です。DGX Spark のメモリの値(meminfo と torch のピーク)はすべて GB(10^9 バイト)で表記します。
torch と NVML
allocated/reserved は DiT プロセスの PyTorch ピークです。カード全体の NVML は 2 Hz のサンプリングで他のプロセスの CUDA コンテキストを含み、下限値です。
  • ほとんどの条件はプロンプト 1 つ・seed 1 つです。DiT ベンチマークは読み込み直後の 1 回目の呼び出しを計測しています。
  • 画質の指標は客観値で、見た目の良し悪しとは別です。衣装の漏れと写り込みは目視による評価です。
  • 3 人目のキャラクターを使う run の 3 枚目は 2 枚目の複製で、メモリと時間だけを表します。
  • 10/18 の run は各 1 回で、VRAM は記録していません。

公開しない素材:差し替え実験の第三者の参照動画とそこから派生したすべての出力、改名前の UI のスクリーンショット、パスやホスト名を含む生の記録。

ソースコードとアーキテクチャ解説を近日公開

用語集

表やグラフのラベルの意味です。

DiT
H3 と Qwen-Image の中核となる拡散 Transformer です。一連のノイズ除去ステップでノイズを画像に変え、通常は run の中で最も重いステージです。
DiT ステージとノイズ除去ステップ
DiT ステージは DiT の呼び出し全体で、すべてのノイズ除去ステップと準備・解放を含みます。ノイズ除去ステップはそのループの 1 回で、「1 ステップの p50」はその中央値です。
PAI 8
Alibaba PAI が MiniMax H3 向けに公開している公式の 8 ステップ高速化 LoRA(MiniMax-H3-FL2VA-Acc-8Step と -Ref2VA-Acc-8Step)です。Parallel Decoding Distillation で学習され、rank 64、BF16 です。
Turbo 8/Turbo 4(lx8/lx4)
LightX2V による MiniMax H3 Turbo LoRA で、8 ステップ用と 4 ステップ用があります(コンポーネント ID の「lx」)。fl2v 8 ステップ v1.0 と 4 ステップ v1.2(768p)、ref2v 8 ステップ v1.0(768p)と 4 ステップ v0.1 を使っています。
オリジナル 50 ステップ
高速化 LoRA なしの MiniMax H3 の元の重みで、ノイズ除去は 50 ステップです。
BF16・FP8・INT8・NF4
DiT の重みの数値形式です。BF16(16 ビット、公式の精度)、FP8 と INT8(8 ビット)、NF4(4 ビット)。精度が低いほどメモリは少なくて済みます。NF4 の 3 種はいずれも読み込みに失敗しました。
AdaLN online/fixed/off
DiT がステップごとの AdaLN 変調を得る方法です。fixed はその LoRA とステップ数向けに事前計算した sidecar ファイルから読み込みます(PAI の LoRA と、実験 04 の Turbo 4)。online は呼び出しのたびに重みから作り直し、off は毎ステップ各ブロックの中で計算します。3 つともデコード後の出力は同一でした。
SDPA(exact)
注意機構を既定の FP8 attention ではなく、PyTorch の scaled-dot-product attention で正確に計算します。BF16 の重みで LoRA なしのときは公式の精度になります。
SubBlock
トークン列のサブブロック上で行うスパースな注意機構(上流の subblock_sparse_attn)で、近似計算です。
host/drop
呼び出し後の DiT の重みの扱いです。host は GPU 上のコピーを解放して重みを pinned のメインメモリに残し、次の呼び出しでそのまま戻します。drop は解放し、次の呼び出しで読み込み直します。出力は変わりません。
レイヤーストリーミング
RTX 5080 の DiT はすべて、pinned のメインメモリからブロック単位でストリーミングして実行しています(block offload、prefetch 1、pinned の上限 24 GiB)。これで 16 GB のカードでもメモリより大きな DiT を動かせます。
t2va の行は fl2va の DiT
テキストのみ(t2va)の run は FL2VA の DiT バリアントを使います。FL2VA の重みはテキストのみと先頭フレームの両方のタスクに対応し、AdaLN の sidecar も両方をカバーしています。

定義は Phasyn Studio のリポジトリ(コンポーネント目録と runtime の説明、commit c5d9310。ソースはまだ公開していません)と 2 つの LoRA のモデルカードによるものです。

テスト環境

2026-10-19 に各マシンから読み取りました。このページの run は 2026-10-17 と 2026-10-18 のものです。読み取れなかった項目は「未記録」としています。

ソフトウェア

Phasyn Studio
commit c5d9310(2026-10-18)
PyTorch
2.14.1+cu130(CUDA 13.0、cuDNN 9.24)、Python 3.12.14。PC のすべての runtime で同じで、GB10 runtime のロックファイルも同じビルドを指定しています
NVIDIA ドライバー(PC)
615.71.09(CUDA driver 13.4)
OS(PC)
Debian GNU/Linux 13、Linux 6.12
DGX Spark の OS・ドライバー・CUDA
未記録

重み

MiniMax H3
MiniMaxAI/MiniMax-H3、revision 42ed227
PAI 8 LoRA
alibaba-pai/MiniMax-H3-Acc-LoRAs(FL2VA と Ref2VA の Acc 8 ステップ)
Turbo LoRA
lightx2v/Minimax-h3-Turbo:fl2v 8 ステップ v1.0、fl2v 4 ステップ v1.2、ref2v 8 ステップ v1.0、ref2v 4 ステップ v0.1
Qwen-Image 2.1
Qwen/Qwen-Image-2.1、revision d26bb61
Qwen3-VL-4B(画像からプロンプト)
snapshot ebb281e

ハードウェア

CPU(PC)
Intel Core i9-13900K、24 コア/32 スレッド
メモリ(PC)
62.6 GiB
RTX 5080
16 GB、PCIe 5.0 ×16
RTX 3060
12 GB、PCIe 4.0 ×4 接続
DGX Spark
GB10、128 GB のユニファイドメモリ
ネットワーク
PC から DGX Spark:PC 側 1 GbE、ルーター経由、ping 約 1.2 ms

13 の実験

各実験の問い、方法、結論、注意点です。数値は上の速度表にあります。

  1. 01DiT ベンチマーク:H3 DiT 40 種どの DiT バリアントが最も速く、VRAM が少ないか。量子化・高速化・AdaLN の設定で出力は変わるか。2026-10-17

    同じテキスト条件・同じ参照 latent・同じ seed(42)で、DiT コンポーネントだけを入れ替えました(FP8/INT8/BF16/NF4 × オリジナル 50 ステップ/PAI 8/Turbo 8/Turbo 4、attention と AdaLN の設定違いを含む)。テキストのみ(t2va)とキャラクター画像 2 枚(ref2va)で、768×448・124 フレームです。読み込めた DiT はすべて RTX 5080 のレイヤーストリーミングで実行しています。DiT コンポーネント 40 種を計測し、37 種が動画を出力、NF4 の 3 種は読み込みに失敗しました。テキスト条件は DGX Spark の te-gb10 で 1 回だけ計算して共有しています。

    結論

    • 速度はまず高速化方式、次に量子化で決まります。同じ高速化なら INT8 は FP8 より 3.6–10.2% 速く、BF16 は 1.6–2.0 倍遅く、オリジナル 50 ステップは PAI 8 より 6.0–6.4 倍遅くなります(ノイズ除去の計算時間)。
    • テキストのみの最速は INT8・PAI 8(DiT 33.2 s、ノイズ除去 26.0 s)で、本番の dit-5080(FP8・PAI 8)は 37.8 s/28.9 s です。参照ありの最速は INT8・Turbo 4(83.9 s/74.4 s)、本番の FP8・PAI 8 は 120.9 s/115.5 s です。
    • 実験 01 は 2026-10-17 に、コールドロード直後の初回呼び出しを計測しています。2026-10-18 の本番 run は読み込み済みの DiT による fl2va の呼び出しで 31.7–38.7 s(ウォームになってからは 31.7–33.2 s)、ここでの同じ dit-5080 は 37.8 s です。行の比較は同じ実験の中だけで行ってください。
    • AdaLN モードと使用後の解放(host/drop)は出力を変えません(デコード後の MD5 が一致)。ただし online の AdaLN は呼び出しごとにステップ外で 23–32 s 余分にかかります(fixed 2–8 s、off 2–3 s)。
    • 参照ありでは PAI 8 と Turbo 8 が黒背景の参照画像を画面に貼り付けました(124 フレーム中 21–22、37–43 フレーム)。Turbo 4 とオリジナルは 0 フレームです。NF4 の 3 種は、量子化重みに comfy_quant メタデータがなくローダーに拒否されました。

    注意点

    • 各条件でプロンプト 1 つ・seed 1 つです。計測は読み込み直後の 1 回目の呼び出しのみで、読み込み時間はページキャッシュの影響を受けます。
    • テキストと参照のエンコードは 1 回だけ計算して再利用したため、各行の実行時間は DiT+デコード+多重化だけで、エンドツーエンドではありません。
    • 参照画像 2 枚は透過 PNG で、モデル入力時に透過部分が黒くなるため、貼り付けが特に目立ちます。
    速度表の 40 行 →
  2. 02キャラクター差し替え実験 R1–R6キャラクター画像 2 枚で参照動画の 2 人を差し替えられるか。どのプロンプトが有効で、どれだけ時間がかかるか。2026-10-18

    ref2va-pc で実行しました。テキストエンコードは DGX Spark の te-gb10、参照動画のエンコードは RTX 5080(R3/R6 系列は RTX 3060)、参照音声のエンコードと音声デコードは RTX 3060、DiT と映像デコードは RTX 5080 です。プロンプトの書き方、透過と白背景のキャラクター画像、PAI 8 と Turbo 4 を比較しました(seed 42、768×448、124 フレーム)。

    結論

    • プロンプト v1(参照動画を fully_preserved)は元のキャラクターの外見まで写しました(R1、R2)。v2 は動画をカメラと動きだけの weak_reference にして差し替える衣装を明記し、2 人とも差し替えに成功しました(R5)。
    • PAI 8+画像 2 枚+参照動画 5.17 秒で、DiT 456.6–480.6 s、全体 581.8–607.4 s でした。DiT のシーケンス長は 79,296–80,832 行で、画像 2 枚だけの場合(35,136)の約 2.3 倍です。
    • 参照動画のエンコードは venc-5080 で約 71.9–73.7 s、venc-3060 で約 247.6–250.2 s だったため、本番の流れは RTX 5080 に切り替えました。
    • Turbo 4 は失敗しました。R3/R6 はパイプラインが 8 ステップ固定のため LoRA のサンプリング契約に拒否され(INVALID_ARGUMENT)、R3b は DiT で GPU_OOM(追加 1.08 GiB が必要、空き 1.07 GiB)、R6b は途中で取り消しました。

    注意点

    • seed は 1 つだけで、差し替えの品質は目視による判断です。
    • R3 系列は参照動画を RTX 3060 でエンコードしたため、venc 時間は R1/R2/R5 と同列に比べられません。
    • これらの run の te-gb10 はテキストエンコーダーを 2 つ読み込んでいたため(実験 11 で修正)、テキストエンコードのメモリ値は高めです。
    速度表の 7 行 →
  3. 03VAE:常駐かオンデマンドかRTX 5080 上の映像 VAE プロセスは読み込んだままにするか、使うときだけ起動するか。2026-10-18

    vae-5080(映像デコード)と venc-5080(参照動画エンコード)の重みは pinned メモリに置き、呼び出しのたびに GPU へ転送します。両方常駐、venc だけ停止、両方停止の 3 構成で、コールドスタート、初回とウォームの呼び出し、DiT の速度、空きメモリを比較しました。

    結論

    • オンデマンド読み込みはレンダリングごとに約 24–27 s 増えます(見積もり。コールドスタートは vae-5080 11.9–15.8 s、venc-5080 8.6–10.7 s、初回呼び出しはデコード +1.1–1.8 s、エンコード +0.8 s)。
    • DiT の速度は変わらず(ノイズ除去 463.2 s、常駐時 463.8–464.3 s)、latent はビット単位で一致しました。利点は DiT 中の空きメモリが 19.1 → 34.3 GiB に増えることだけなので、常駐を維持しました。
    • Turbo 4(online AdaLN)+参照動画は両方の VAE を止めたときだけ収まりました。DiT 252.8 s、カード全体の余裕は約 0.3 GiB で、venc だけ止めた構成では GPU_OOM でした。

    注意点

    • 24–27 s はコールドスタートと初回呼び出しの差を足し合わせた見積もりで、1 回のエンドツーエンド計測ではありません。
    • 「常駐」とはプロセスと CUDA コンテキスト(各約 0.9 GiB)が 5080 に残ることで、重みは呼び出しごとに GPU へ転送します。
  4. 04Turbo 4 と AdaLN の事前計算Turbo 4 で事前計算した AdaLN を使えば、VAE 2 つを常駐させたまま RTX 5080 に収まるか。出力は変わるか。2026-10-18

    Turbo 4(INT8、lx4 LoRA)用に 465 MB の AdaLN 事前計算ファイルを作り、毎回のオンライン計算をなくしました。R2・R5 の条件で VRAM と DiT 時間を計測し、オンライン版と latent を値ごとに比較しました。

    結論

    • VAE 2 つを常駐させても収まりました。DiT 229.3–235.3 s(PAI 8 は約 470 s)、torch allocated/reserved は 11,644/13,070 MiB(PAI 8 は 11,418/12,842)、実質の余裕は 1.40 GiB(PAI 8 は 1.61 GiB)です。
    • オンライン版と latent は完全に一致しました(動画 1,193,472 値、音声 13,248 値、最大差 0)。
    • 画質面では seed 42 で元のキャラクターの白いフリルのスカートが漏れ(実験 08 で 4/4 の seed すべてで確認)、ref2va-pc は PAI 8 のままにしました。

    注意点

    • テキストと参照のエンコードは R2/R5 の出力を再利用しているため、ここでの時間は DiT(R5 条件ではデコードも)だけです。
    速度表の 2 行 →
  5. 05差し替えの上限(参照動画 768)参照動画 768 のとき、1 セグメントで何フレーム・何人まで RTX 5080 に収まるか。2026-10-18

    VAE 2 つを常駐させた本番構成で ref2va-pc 全体を実行し(seed 42)、PAI 8 と Turbo 4 fixed で 3 人・124 フレームと 2 人・141 フレームを試しました。3 枚目のキャラクター画像は 2 枚目の複製で、メモリと時間だけの確認です。

    結論

    • PAI 8:2 人・124 フレームは可能(余裕 1.61 GiB)。3 人・124 フレームは GPU_OOM(FFN に 2.49 GiB 必要、空き 2.24 GiB)、2 人・141 フレームも GPU_OOM(連続 2.34 GiB が必要、空き 1.55 GiB+断片化 1.71 GiB)でした。
    • Turbo 4 fixed:3 人・124 フレームは GPU_OOM、2 人・141 フレームは成功しました(DiT 269.9 s、余裕 0.695 GiB)。ただし画質の問題は実験 08 を参照してください。
    • 3 件の OOM はすべて DiT の開始直後(完了ステップ 0)に起きましたが、テキストと参照のエンコードが先に終わるため、失敗した run でもそれぞれ 118.0–133.5 s かかりました。

    注意点

    • 3 人目は複製画像のため、実際の 3 人の画質は表しません。
    • OOM の境界はメモリの断片化に左右され、入力が変われば変わる可能性があります。
    速度表の 4 行 →
  6. 06参照動画の短辺を 448 に参照動画の前処理を 448 に下げると、速度・VRAM・画質はどうなるか。2026-10-18

    R5 の条件(PAI 8、2 人、124 フレーム、seed 42)のまま、参照動画の前処理の短辺だけを 768 から 448 に変えました(1280×720 → 800×448)。出力は 768×448 のままです。768 の対照 run が R5 とビット単位で一致すること、Studio の UI と MCP の結果が一致することも確認しました。

    結論

    • 1 セグメントの合計は 600.5 → 297.2 s、DiT は 470.7 → 223.9 s(ノイズ除去 1 ステップの p50 は 57.9 → 27.5 s)、参照動画のエンコードは 73.7 → 28.6 s、DiT のシーケンス長は 80,832 → 52,544 になりました。
    • DiT の torch allocated/reserved は 11.15/12.54 GiB → 8.24/10.40 GiB です。
    • 画質(seed 1 つ):キャラクターと衣装は保たれ、カット位置も同じです。動きは控えめになり(フレーム間変化の中央値 3.02、768 は 4.02、元動画 6.22)、口の動きも小さくなりました。
    • 768 の対照 run は latent とデコード後の動画が R5 とビット単位で一致し、UI と MCP で実行した 448 の結果もビット単位で一致しました。

    注意点

    • 画質は seed 1 つだけの確認で、448 で他の seed でも衣装が漏れないかは未検証です。
    • R5 のテキストエンコードはウォーム呼び出し、768 の対照 run は再起動後の初回(79.9 s)だったため、合計時間は R5 と比較しています。
    速度表の 3 行 →
  7. 07参照動画 448 での差し替え上限参照動画 448 のとき、1 セグメントをどこまで長く、何人まで入れられるか。2026-10-18

    参照動画 448、PAI 8、seed 42 で、VAE 2 つを常駐させた本番構成のまま 2 人 124/141/158 フレームと 3 人 124 フレームを試し、成功した 5 点で VRAM モデルを当てはめました。3 枚目のキャラクター画像は複製です。

    結論

    • すべて成功しました。2 人 124/141/158 フレーム(DiT 223.9/257.4/282.3 s、合計 297.2/339.6/365.7 s)、3 人 124 フレーム(322.5/411.2 s)で、余裕は 4.52/4.16/3.76/3.20 GiB です。
    • VRAM モデル:allocated のピーク ≈ 2,892 MiB+0.1056 MiB × シーケンス長(5 点の残差 35 MiB 未満)。実測で余裕 1.6 GiB は安全、0.8 GiB は不十分です。
    • 上限はワンクリック差し替えに反映済みです(1–2 人は 1 セグメント最大 158 フレーム、3 人は 124 フレーム)。141 フレームの出力ではショット 1 に元動画の字幕消しのぼかしが写り込みました。

    注意点

    • 3 人目は複製画像です。175 フレーム以上はモデルによる推定のみで計測値ではないため、このページには描いていません。
    速度表の 3 行 →
  8. 08Turbo 4 の複数 seed 比較Turbo 4 で元のキャラクターの衣装が漏れるのは毎回起きるのか。2026-10-18

    R5 の条件(参照動画 768、2 人、124 フレーム)で seed 42/7/1234/31337 を使い、PAI 8 と Turbo 4 fixed を比較しました。seed 42 はパイプライン全体、ほかの seed は R5 の条件エンコードを再利用し、DiT とデコードだけを再実行しています。

    結論

    • Turbo 4 は 4/4 の seed で元のキャラクターの白いフリルのスカートが漏れ、4/4 で字幕消しのぼかしも写しました。PAI 8 も漏れますが(明確 1、半透明の残像 2、なし 1)、ぼかしは 0/4 でした。
    • 速度は PAI 8 の DiT が 465.8–472.6 s、Turbo 4 が 229.2–235.5 s でした。
    • 結論として ref2va-pc は PAI 8 のままとし、Turbo 4 の下書きルートは追加しません。速さが必要なら PAI 8+参照動画 448(DiT 224 s)を使います。

    注意点

    • 4 つの seed は失敗率を示すものではなく、衣装の漏れは目視による段階評価です。
    速度表の 6 行 →
  9. 09参照コストに関する外部分析の検証参照素材が ref2va を遅くするという外部分析は正しいか。コストは実際どこにあるか。2026-10-18

    外部分析をコード、run の記録、payload と 1 項目ずつ照合しました。R1 の DiT シーケンスの内訳を分解し、8 つの run からステップ時間とシーケンス長の関係を当てはめ、2026-10-17 の基準 run E1–E4 も並べています。

    結論

    • 大筋は正しいものの、R1 の主なコストは参照画像ではなく参照動画でした。79,268 行のうち参照動画 37,296(47%)、Qwen ビジョン 16,944(21%)、参照画像 10,880(14%)、生成する動画 12,432(16%)、テキストと音声 1,716 です。
    • ステップ時間のモデルは step(L) ≈ 1.68e-4·L+6.81e-9·L² 秒で、13k–81k 行で誤差は約 ±3% です(RTX 5080、FP8・PAI 8)。
    • 報告の誤り:映像デコードは実際には FP32 で、aenc の 6.98 s は主に同じファイルのダウンロード待ちでした。テキストエンコードの 2 段階化、コスト記録、reference_video_short_edge パラメーター(実験 06)を実装済みです。

    注意点

    • 時間モデルは RTX 5080・FP8・PAI 8・出力 768×448×124 にのみ当てはまります。「seed だけ変えるなら条件エンコードを再利用して約 100 s 節約」は推定で、未実装・未計測です。
    速度表の 5 行 →
  10. 10フロントエンドと MCP の実地テストUI と MCP で実験を最初から最後まで操作すると、どんな問題に当たるか。2026-10-18

    実際にインストールした MCP と Studio の UI で実験 06 の 448 実験を準備・実行し、遭遇した問題をすべて記録して、2 つの経路の出力を比較しました。

    結論

    • 第 1 段階で 26 件の問題があり、うち major 3 件(MCP が大きな出力を落とす、run の入力が見えない、推論ページの素材順が Studio と違う)はすべて修正済みです。
    • 第 2 段階では新たに 7 件が見つかりました(latent のハッシュに読み込みメタデータが含まれる、音声コンポーネントのコールド呼び出しが数値的に再現しない、テキストエンコードが再起動後の初回に約 50 s 遅い など)。うち 2 件は修正済みです。
    • UI と MCP で実行した 448 の結果はビット単位で一致しました。

    注意点

    • スクリーンショットは改名前の旧 UI のため公開しません。サイトの操作動画は英語 UI で別途録画しています。
  11. 11DGX Spark でのリバースプロンプトとメモリ画像のリバースプロンプトを DGX Spark に置き、常駐の te-gb10 と共存させてメモリは足りるか。2026-10-18

    画像のリバースプロンプト(qimg-vision-gb10、Qwen3-VL-4B BF16)を DGX Spark に置いて te-gb10 と共存させ、修正後にメモリ・読み込み・呼び出し時間を計測しました。あわせて、te-gb10 が ref2va のたびにテキストエンコーダーを重複して読み込む問題も修正しました。

    結論

    • 修正前は te-gb10 が ref2va のあとに同一のテキストエンコーダーをもう 1 つ読み込み、51.5 GB 余分に使っていました。共有後は 1 つだけになり、ref2va 呼び出しのピークは allocated/reserved 56.81/59.66 GB、終了後は 51.69/52.30 GB で、出力は R5 とビット単位で一致しました。
    • GB10 はユニファイドメモリのため、利用可能量は MemAvailable − 4 GiB(64.10 GB)としました。torch の mem_get_info(回収可能なページキャッシュを含まず 8.53 GB)は使いません。
    • 4B のリバースプロンプトは読み込み 62.5 s、キャプション 5.3 s、解析 85.8 s でした。te-gb10 と共存したときの MemAvailable の最低値は 57.29 GB で、常駐させると約 11.6 GB 増えます。

    注意点

    • DGX のメモリ値は GB(10^9 バイト)です。共存時の te-gb10 の ref2va ピークは推定のみで未計測です。
    • キャプションには誤りがありました(横方向のろくろ目を縦縞と記述)。品質の確認は画像 1 枚だけです。
    速度表の 2 行 →
  12. 12画像生成の検証(Qwen-Image 2.1)RTX 5080 上の Qwen-Image 2.1 の出力は作者の以前の画像ツール DiT Studio と一致するか。動画コンポーネントを常駐させたまま収まるか。2026-10-18

    初めての GPU 検証で 30 run(API 28、Image Studio 2)を実行しました。過去の 8 ケースをピクセル単位で比較し、BF16 phase・BF16 stream・Qwen-Image GGUF Q4_K_M の 3 つの DiT コンポーネントの時間と VRAM、VAE デコードの full と tiled、途中プレビューのコストを計測しました。GPU のステップはすべて RTX 5080、合成は CPU です。

    結論

    • 8 ケースすべてで DiT Studio の出力と RGBA がピクセル単位で一致しました(最大差 0)。BF16 phase と stream の latent はビット単位で一致し、バッチと UI の画像も単発 run と同一でした。
    • 当時、本番状態で完走したのは GGUF ルートだけでした。BF16 phase は事前チェックで拒否(14.77 GiB 必要、空き 11.66 GiB)、BF16 stream は DiT が完了(1024² で 32.5–33.2 s)した直後に VAE デコードで OOM。原因はテキストエンコードと DiT が呼び出し後に CUDA キャッシュを解放しないことでした。
    • VAE デコードは 1024² の full で 0.74–0.79 s(allocated 7.05 GiB)。tiled ではピンクの細い縦線が出ます。1536² の full は 16 GB のカードでは実行できません。
    • 途中プレビュー(4 ステップごと)は 11/11 枚が出力され、GPU の 1 ステップ時間は変わらず(713.8 ms と 712.7 ms)、メインメモリは 1.26 GiB 増えました。

    注意点

    • GGUF ルートは Q4_K_M の微調整重みで、オリジナルの重みではありません。画像のリバースプロンプトは今回の範囲外です。
    • run ごとの数値はアーカイブ内の比較ページから取っています(元の run 記録はアーカイブにありません)。
    速度表の 17 行 →
  13. 13画像 DiT 修正の検証呼び出し後に CUDA キャッシュを解放するようにしたら、BF16 stream は本番状態で最後まで動くか。2026-10-18

    「呼び出しごとに CUDA キャッシュを解放し、失敗時は先にフレームを破棄する」修正のあと、RTX 5080 の本番状態(H3 の vae-5080/venc-5080 常駐)で実験 12 で失敗した t2i-pc を再実行しました。同じプロンプト(陶器のカップ)、1024²、40 ステップ、seed 42、VAE full で、プレビューなしと 4 ステップごとのプレビューを比べました。

    結論

    • 合格です。エンドツーエンド 47.9 s(テキストエンコード 12.15 s、DiT 33.04 s、VAE 1.82 s)、カード全体の NVML ピークは 11,849 MiB で、画像は修正前の参照出力とピクセル単位で一致しました。
    • 4 ステップごとのプレビューでは 11 枚すべてが出力され、GPU の 1 ステップ p50 は 9.0 ms(+1.1%)増えただけで、エンドツーエンドは 43.0 s でした(テキストエンコードのプロセスはウォーム)。
    • 設定済み:t2i-pc と i2i-pc の DiT を BF16 stream に切り替え、プレビュー用の VAE を有効にしました。

    注意点

    • i2i、4 枚バッチ、1536² は修正後の GPU でまだ再検証していません。プレビューの格子状の模様は手法そのものによるものです。
    速度表の 2 行 →