
AI 生成 · Powered by MiniMax H3
黎明崖邊
76.0 s端對端fl2varun 82d036a7dit-5080Seed 101
- 文字編碼· DGX Spark (GB10)2.3 s
- 首幀編碼(影片 VAE)· RTX 50806.1 s
- DiT 去噪· RTX 508038.7 s
- 影片解碼· RTX 508027.7 s
- 音訊解碼· RTX 30605.8 s
- 封裝· PC CPU0.5 s
聲音(H3 生成):高空強風、斗篷翻動聲、遠處的瀑布聲
BENCHMARKS · RTX 5080 · DGX SPARK · RTX 3060
MiniMax H3 與 Qwen-Image 2.1 在作者兩台機器、三顆 GPU 上實際執行的結果:一台 PC 裡的 RTX 5080 與 RTX 3060,加上一台 DGX Spark。每一步都標明在哪個裝置上執行。用下面的表格,替自己的硬體挑一套設定;失敗的紀錄也照實列出。
首幀生成影片 fl2va
57.2–76.0 s
5.17 秒、768×448、124 幀,含聲音
10/18 實測 4 次 · 端對端
76 s 是 10/18 第一個 fl2va run(首幀編碼 6.1 s、音訊解碼 5.8 s;其後三次約 1 s),DiT 與影片解碼也比較慢。
參考圖生成影片 ref2va
105.0–108.0 s
1 張參考圖,同樣的輸出規格
10/18 實測 2 次 · 端對端
Qwen-Image 2.1 靜態圖
25.8–26.9 s
1152×672、40 步
10/18 實測 4 次 · 端對端
ref2va · run 5adf4237 · 10/18 實測
文字編碼
te-gb108.3 s參考/首幀編碼
venc-50805.5 saenc-30601.5 sDiT 去噪
dit5080-ref2va-fp8-pai868.0 s影片與音訊解碼
vae-508022.5 saudio-30600.9 s封裝
mux0.3 s2026-10-17 的早期 run 把參考編碼放在 RTX 3060,之後改到 RTX 5080(快約 3.4 倍)。
先看這六點,再到速度表找你的配置。
6.0–6.4×
原版 50 步 ÷ PAI 8
PAI 8 步比原版 50 步快 6.0–6.4 倍;同一種加速下,INT8 只比 FP8 快 3.6–10.2%(以去噪運算時間計;都是單一 seed 的單次冷呼叫,小差距僅供參考)。
看數據600.5 → 297.2 s
一段的總時間
換角 run 裡,參考影片佔 DiT 序列 47%。把參考影片前處理成 448,一段從 600.5 s 降到 297.2 s。
看數據15.91 / 15.92 GiB
整卡 NVML 峰值
有參考素材時 DiT 保留最多 13.6 GiB,整卡峰值 15.91/15.92 GiB。實測 1.6 GiB 餘量安全,0.8 GiB 不安全。
看數據3.4×
參考影片編碼:RTX 5080 對 RTX 3060
全精度的 Qwen3-VL 文字編碼器(te-gb10)留在 DGX Spark:常駐約 52 GB,呼叫時最高約 60 GB,遠超過 16 GB 的卡在 DiT 旁還挪得出的空間。參考影片編碼從 RTX 3060 移到 RTX 5080:從 248–250 s 變成 72–74 s。
看數據4 / 4
漏出服裝的 seed
在換角條件下(768 參考影片、2 個角色),Turbo 4 的 DiT 是 229–236 s,PAI 8 要 466–473 s;但 4 個 seed 全都漏出原角色的服裝,所以正式的 ref2va 維持 PAI 8。
看數據每一列是一次實際執行:管線、DiT 變體、輸出、每一步的時間與裝置、DiT 時間、端對端總時間與 VRAM。先顯示重點列;載入全部資料後可以排序與篩選每一列。
重點 32 列(共 77 列) ·
| Run | 管線與輸入 | DiT 變體 | 步驟與裝置 | s?實際經過時間 / 去噪運算 | s? | GiB?allocated / reserved整卡 | 狀態 |
|---|---|---|---|---|---|---|---|
fl2va首幀:10/18 生成的 Qwen-Image 靜態圖 | FP8 · PAI 8768×448 · 124 幀 dit-5080 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 38.7 | 76.0 | 未提供 | 成功 | |
fl2va首幀:10/18 生成的 Qwen-Image 靜態圖 | FP8 · PAI 8768×448 · 124 幀 dit-5080 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 32.0 | 57.2 | 未提供 | 成功 | |
fl2va首幀:10/18 生成的 Qwen-Image 靜態圖 | FP8 · PAI 8768×448 · 124 幀 dit-5080 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 31.7 | 57.4 | 未提供 | 成功 | |
fl2va首幀:10/18 生成的 Qwen-Image 靜態圖 | FP8 · PAI 8768×448 · 124 幀 dit-5080 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 33.2 | 58.6 | 未提供 | 成功 | |
ref2va1 張參考圖:10/18 生成的角色設定圖 | FP8 · PAI 8768×448 · 124 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 70.0 | 108.0 | 未提供 | 成功 | |
ref2va1 張參考圖:10/18 生成的角色設定圖 | FP8 · PAI 8768×448 · 124 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 68.0 | 105.0 | 未提供 | 成功 | |
t2va只有文字提示詞 | FP8 · PAI 8768×448 · 124 幀 dit-5080 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 37.8去噪運算28.9 | 非端對端run 64.0 s | 3.66 / 4.93整卡 7.22 | 成功 | |
t2va只有文字提示詞 | INT8 · PAI 8768×448 · 124 幀 dit5080-fl2va-int8-pai8 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 33.2去噪運算26.0 | 非端對端run 60.2 s | 3.65 / 4.93整卡 7.22 | 成功 | |
t2va只有文字提示詞 | BF16 · PAI 8768×448 · 124 幀 dit5080-fl2va-bf16-pai8 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 65.2去噪運算58.5 | 非端對端run 91.7 s | 4.67 / 6.37整卡 8.66 | 成功 | |
t2va只有文字提示詞 | FP8 · Turbo 4768×448 · 124 幀 dit5080-fl2va-fp8-lx4 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 44.6去噪運算33.5 | 非端對端run 73.4 s | 6.18 / 7.32整卡 9.63 | 成功 | |
t2va只有文字提示詞 | INT8 · Turbo 4768×448 · 124 幀 dit5080-fl2va-int8-lx4 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 40.6去噪運算31.5 | 非端對端run 67.8 s | 6.17 / 7.31整卡 9.61 | 成功 | |
t2va只有文字提示詞 | FP8 · Turbo 8768×448 · 124 幀 dit5080-fl2va-fp8-lx8 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 57.8去噪運算48.4 | 非端對端run 85.0 s | 6.18 / 7.32整卡 9.63 | 成功 | |
t2va只有文字提示詞 | INT8 · 原版 50 步768×448 · 124 幀 dit5080-fl2va-int8-base | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 174.5去噪運算166.6 | 非端對端run 201.7 s | 4.88 / 5.96整卡 8.27 | 成功 | |
t2va只有文字提示詞 | BF16 · 原版 50 步768×448 · 124 幀 dit5080-fl2va-bf16-base-exact官方精度 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 413.5去噪運算407.8 | 非端對端run 440.1 s | 6.31 / 8.93整卡 11.24 | 成功 | |
ref2va2 張角色參考圖(透明 PNG) | FP8 · PAI 8768×448 · 124 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 120.9去噪運算115.5 | 非端對端run 144.2 s | 6.43 / 10.13整卡 12.42 | 成功 | |
ref2va2 張角色參考圖(透明 PNG) | INT8 · PAI 8768×448 · 124 幀 dit5080-ref2va-int8-pai8 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 119.4去噪運算110.3 | 非端對端run 146.7 s | 6.43 / 10.09整卡 12.37 | 成功 | |
ref2va2 張角色參考圖(透明 PNG) | FP8 · Turbo 4768×448 · 124 幀 dit5080-ref2va-fp8-lx4 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 91.1去噪運算78.6 | 非端對端run 118.2 s | 8.52 / 12.27整卡 14.58 | 成功 | |
ref2va2 張角色參考圖(透明 PNG) | INT8 · Turbo 4768×448 · 124 幀 dit5080-ref2va-int8-lx4 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 83.9去噪運算74.4 | 非端對端run 111.6 s | 8.51 / 12.22整卡 14.53 | 成功 | |
ref2va2 張角色參考圖(透明 PNG) | NF4 · Turbo 4768×448 · 124 幀 dit5080-ref2va-nf4-lx4AdaLN off | RTX 5080 | — | — | 未量測 | 載入失敗 | |
ref2va2 張角色參考圖(透明 PNG) | INT8 · Turbo 8768×448 · 124 幀 dit5080-ref2va-int8-lx8 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 140.7去噪運算130.0 | 非端對端run 167.6 s | 8.51 / 12.22整卡 14.53 | 成功 | |
ref2va2 張角色參考圖(透明 PNG) | INT8 · 原版 50 步768×448 · 124 幀 dit5080-ref2va-int8-base | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 682.9去噪運算672.3 | 非端對端run 709.9 s | 7.22 / 10.86整卡 13.16 | 成功 | |
ref2va2 張角色參考圖(透明 PNG) | BF16 · 原版 50 步768×448 · 124 幀 dit5080-ref2va-bf16-base-exact官方精度 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 1,515.5去噪運算1,507.3 | 非端對端run 1,543.0 s | 8.37 / 13.06整卡 15.37 | 成功 | |
ref2va2 張角色圖+5.17 秒參考影片(含聲音) | FP8 · PAI 8768×448 · 124 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 470.7去噪運算464.3 | 600.5 | 11.15 / 12.54整卡 15.70 | 成功 | |
ref2va2 張角色圖+5.17 秒參考影片(含聲音) | INT8 · Turbo 4768×448 · 124 幀 dit5080-ref2va-int8-lx4 | DGX Spark (GB10)RTX 3060RTX 5080 | — | — | 11.60 / 13.61整卡 14.86 | GPU 記憶體不足 | |
ref2va沿用 R5 的條件編碼 | INT8 · Turbo 4768×448 · 124 幀 dit5080-ref2va-int8-lx4-fixedAdaLN fixed | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 229.3去噪運算227.1 | 非端對端run 256.8 s | 11.37 / 12.76整卡 15.91 | 成功 | |
ref2va2 張角色圖+5.88 秒影片 | FP8 · PAI 8768×448 · 141 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 5080RTX 3060 | — | — | 11.83 / 12.58整卡 15.54 | GPU 記憶體不足 | |
ref2va2 張角色圖+5.88 秒影片 | INT8 · Turbo 4768×448 · 141 幀 dit5080-ref2va-int8-lx4-fixedAdaLN fixed | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 269.9去噪運算266.5 | 407.1 | 12.07 / 12.60整卡 15.76 | 成功 | |
ref2va2 張角色圖+5.17 秒影片,參考影片 448 | FP8 · PAI 8768×448 · 124 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 223.9去噪運算220.3 | 297.2 | 8.24 / 10.40整卡 12.85 | 成功 | |
ref2va2 張角色圖+6.58 秒影片,參考影片 448 | FP8 · PAI 8768×448 · 158 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 5080RTX 3060PC CPU | 282.3去噪運算278.4 | 365.7 | 9.01 / 11.25整卡 14.41 | 成功 | |
ref2va2 張角色參考圖(透明 PNG) | FP8 · PAI 8768×448 · 124 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 117.2去噪運算114.6 | 186.1 | 6.43 / 10.13整卡 12.37 | 成功 | |
ref2va1 張參考圖+參考影片(含聲音) | FP8 · PAI 8768×448 · 124 幀 dit5080-ref2va-fp8-pai8 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 293.6去噪運算290.7 | 541.3 | 9.15 / 11.31整卡 13.60 | 成功 | |
fl2va1 張首幀圖 | FP8 · PAI 8768×448 · 124 幀 dit-5080 | DGX Spark (GB10)RTX 3060RTX 5080PC CPU | 39.0 | 68.3 | 未量測 | 成功 |
時間單位為秒,VRAM 為 GiB(2^30 bytes)。同時執行的步驟(影片與音訊解碼、參考影片與音訊編碼)重疊,所以步驟相加會超過總時間。
圖片管線另列一張表,因為它的步驟與單位都不同。所有 GPU 步驟都在 RTX 5080,合成在 CPU。
重點 6 列(共 23 列) ·
| Run | 管線與輸入 | DiT 變體 | 步驟與裝置 | s?實際經過時間 / 去噪運算 | s? | GiB?allocated / reserved整卡 | 狀態 |
|---|---|---|---|---|---|---|---|
t2i文字提示詞(原創角色) | BF16 · 40 步1152×672 qimg-dit-bf16-5080-streamstream | RTX 5080PC CPU | ≈23.0 | 26.0 | 未提供 | 成功 | |
t2i文字提示詞(原創角色) | BF16 · 40 步1152×672 qimg-dit-bf16-5080-streamstream | RTX 5080PC CPU | ≈23.0 | 26.9 | 未提供 | 成功 | |
t2i文字提示詞(原創角色) | BF16 · 40 步1152×672 qimg-dit-bf16-5080-streamstream | RTX 5080PC CPU | ≈23.0 | 25.9 | 未提供 | 成功 | |
t2i文字提示詞(原創角色) | BF16 · 40 步1152×672 qimg-dit-bf16-5080-streamstream | RTX 5080PC CPU | ≈23.0 | 25.8 | 未提供 | 成功 | |
t2i文字提示詞(陶杯) | GGUF Q4_K_M · 40 步1024×1024 qimg-dit-gguf-5080gguf | RTX 5080PC CPU | 38.6 | 41.2 | 5.07 / 5.59整卡 — | 成功 | |
t2i文字提示詞(陶杯) | BF16 · 40 步1024×1024 qimg-dit-bf16-5080-streamstream | RTX 5080PC CPU | 33.0 | 47.9 | 1.56 / 5.88整卡 9.19 | 成功 |
這些 run 失敗或被取消。失敗前已經花掉的時間也列出來。
| Run | 內容 | 錯誤碼 | 失敗步驟 | 停止前 |
|---|---|---|---|---|
| 實驗 01載入失敗 | ref2va · NF4 · Turbo 4dit5080-ref2va-nf4-lx42 張角色參考圖(透明 PNG) | RUNTIME_ERROR | DiT 載入RTX 5080 | 未執行 |
| 實驗 02 · 9d7d9e6f · R3bGPU 記憶體不足 | ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx42 張角色圖+5.17 秒參考影片(含聲音) | GPU_OOM | DiT 去噪RTX 5080 | 323.9 s |
| 實驗 05 · 58da16b6GPU 記憶體不足 | ref2va · FP8 · PAI 8dit5080-ref2va-fp8-pai82 張角色圖+5.88 秒影片 | GPU_OOM | DiT 去噪RTX 5080 | 118.0 s |
| 實驗 01載入失敗 | ref2va · NF4 · Turbo 8dit5080-ref2va-nf4-lx82 張角色參考圖(透明 PNG) | RUNTIME_ERROR | DiT 載入RTX 5080 | 未執行 |
| 實驗 01載入失敗 | ref2va · NF4 · 原版 50 步dit5080-ref2va-nf4-base2 張角色參考圖(透明 PNG) | RUNTIME_ERROR | DiT 載入RTX 5080 | 未執行 |
| 實驗 02 · 7fa18f97 · R3設定不合法 | ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx42 張角色圖+5.17 秒參考影片(含聲音) | INVALID_ARGUMENT | DiT 去噪RTX 5080 | 287.3 s |
| 實驗 02 · 9597890a · R6設定不合法 | ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx42 張角色圖+5.17 秒參考影片(含聲音) | INVALID_ARGUMENT | DiT 去噪RTX 5080 | 281.4 s |
| 實驗 02 · 07156692 · R6b已取消 | ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx42 張角色圖+5.17 秒參考影片(含聲音) | CANCELLED | 參考編碼(影片 VAE)RTX 3060 | 201.1 s |
| 實驗 05 · f612bb72GPU 記憶體不足 | ref2va · FP8 · PAI 8dit5080-ref2va-fp8-pai83 張角色圖(第 3 張重複)+5.17 秒影片 | GPU_OOM | DiT 去噪RTX 5080 | 131.7 s |
| 實驗 05 · 3ae8e653GPU 記憶體不足 | ref2va · INT8 · Turbo 4dit5080-ref2va-int8-lx4-fixed3 張角色圖(第 3 張重複)+5.17 秒影片 | GPU_OOM | DiT 去噪RTX 5080 | 133.5 s |
| 實驗 09 · dc6453d1 · E1設定不合法 | ref2va · FP8 · PAI 8dit5080-ref2va-fp8-pai82 張角色參考圖(透明 PNG) | INVALID_ARGUMENT | 影片解碼RTX 5080 | 236.8 s |
| 實驗 12 · f16484ff准入拒絕 | t2i · BF16 · 40 步qimg-dit-bf16-5080-phase文字提示詞(陶杯) | 422 | DiT 去噪RTX 5080 | 14.4 s |
| 實驗 12 · 03261cb0GPU 記憶體不足 | t2i · BF16 · 40 步qimg-dit-bf16-5080-stream文字提示詞(陶杯) | GPU_OOM | VAE 解碼RTX 5080 | 43.5 s |
| 實驗 12 · 5c0a3c90准入拒絕 | i2i · BF16 · 40 步qimg-dit-bf16-5080-stream文字提示詞+參考圖 | 422 | VAE 解碼RTX 5080 | 49.7 s |
| 實驗 12 · 947ed5ba准入拒絕 | i2i · GGUF Q4_K_M · 40 步qimg-dit-gguf-5080文字提示詞+參考圖 | 422 | DiT 去噪RTX 5080 | 未執行 |
| 實驗 12 · 3e8b52deGPU 記憶體不足 | i2i · BF16 · 4 步qimg-dit-bf16-5080-stream文字提示詞+參考圖 | GPU_OOM | VAE 解碼RTX 5080 | 20.1 s |
與表格相同的資料,不含主機名稱與檔案路徑。秒數除非欄位寫明是運算時間,都是實際經過時間;VRAM 單位為 GiB。
六段影片與四張靜態圖,都是 10 月 18 日以原創角色 The Courier、透過 Controller API 的正式路由(t2i-pc、fl2va-pc、ref2va-pc)生成。每項只跑一次;時間是 Controller 記錄的步驟時間。
10/18 實測每項各一次網頁版已做響度正規化;原始輸出約 −37~−50 LUFS、AAC 32 kHz。
fl2varun 82d036a7dit-5080Seed 101
聲音(H3 生成):高空強風、斗篷翻動聲、遠處的瀑布聲
fl2varun cfa759dfdit-5080Seed 202
聲音(H3 生成):密集雨聲、屋簷滴水、踩過水窪的腳步、霓虹燈的低鳴
fl2varun 72341805dit-5080Seed 303
聲音(H3 生成):輕拍岩石的海浪、微風、玻璃碎片的清脆聲
fl2varun 7d52714adit-5080Seed 404
聲音(H3 生成):輕微的空氣聲、光點飄過的細微聲響、她的呼吸
ref2varun f083d166dit5080-ref2va-fp8-pai8Seed 505
聲音(H3 生成):呼嘯的風、在水泥上的快步、斗篷拍動、落地的悶響、飛起的鳥
ref2varun 5adf4237dit5080-ref2va-fp8-pai8Seed 606
聲音(H3 生成):溫暖的微風、草浪沙沙聲、遠處鳥鳴、玻璃框碰到指尖的清響
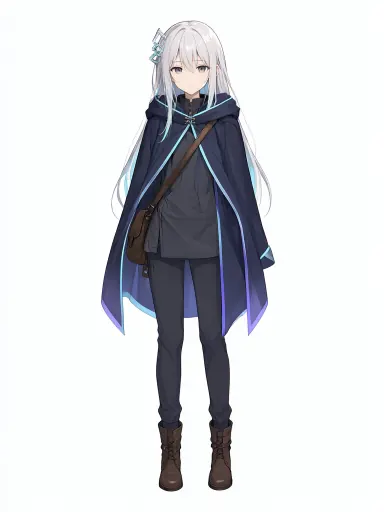
1152×672、40 步;文字編碼、DiT 與 VAE 都在 RTX 5080,合成在 CPU。這些靜態圖也當成 fl2va 的首幀。
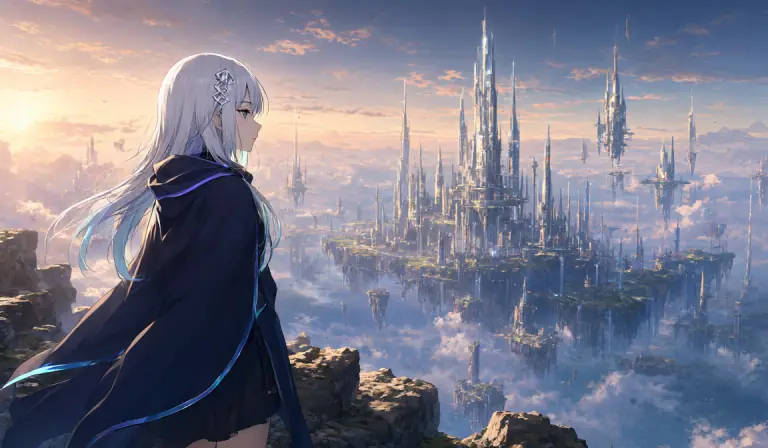 黎明崖邊26.0 srun 3a6d932d
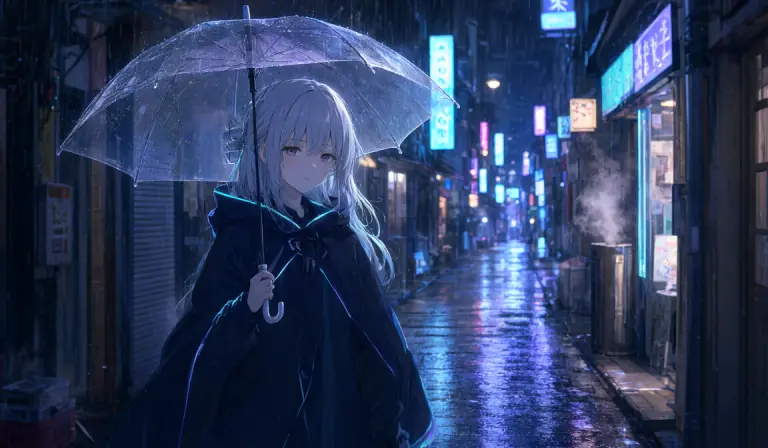 霓虹雨巷26.9 srun 0e2463b8
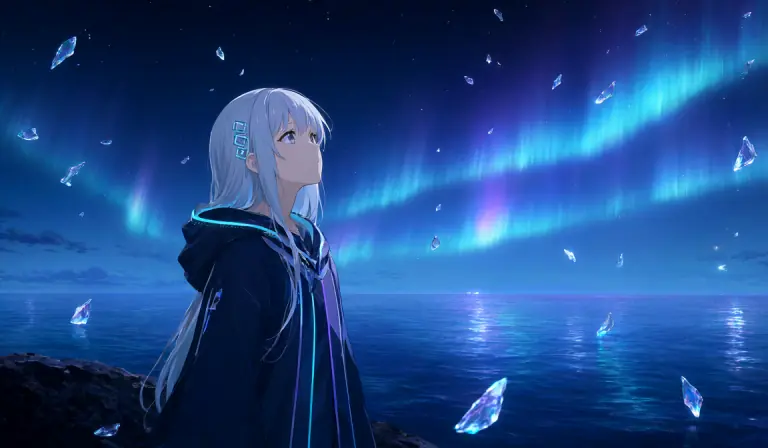 極光海面25.9 srun d47c0fa1
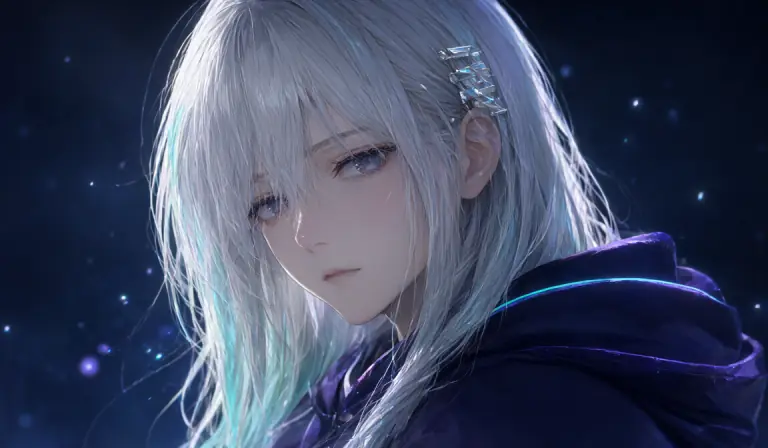 特寫25.8 srun 577fc7a4
同一份文字條件、同一組參考 latent、同一個 seed,只換 DiT 變體。測了 40 個 DiT 變體;37 個成片,3 個 NF4 變體載入失敗。載入成功的 DiT 都在 RTX 5080 以逐層串流執行。
亮藍色是正式使用的 DiT;其餘是同一張 RTX 5080 上的對照組。
實心=Recorder 的去噪迴圈運算;淡色延伸到整個 DiT 階段的實際經過時間(多出的是 AdaLN 準備、輸入組裝與釋放)。數字依序是實際經過時間 · 去噪運算,單位秒。每條都是冷載入後的第一次呼叫(2026-10-17)。2026-10-18 的正式 run 呼叫的是已載入的 DiT:31.7–38.7 s(暖機後 31.7–33.2 s),所以可能比這張圖最快的冷呼叫 33.2 s 還快。
四格同步播放,標籤由網頁疊上;影片本身沒有文字。同一個 prompt、seed 42、768×448、124 幀。
dit-508037.8 sdit5080-fl2va-fp8-lx857.8 sdit5080-fl2va-fp8-lx444.6 sdit5080-fl2va-fp8-base193.3 s聲音來自左上角那一格(H3 生成,沒有對白)。 網頁版已做響度正規化。
左邊是正式使用的 dit-5080(FP8 · PAI 8,DiT 37.8 s),右邊是 BF16 原版 50 步精確 attention(413.5 s)。兩段同步播放。 網頁版已做響度正規化。
ref2va 的 DiT 序列會把參考影片、參考圖與 Qwen 的視覺 token 一起帶進去。序列越長,每一步越慢,而且不是線性變慢。
同時執行的步驟上下並排。灰色斜線是步驟之間沒有歸屬的時間(排程與傳輸)。
R5 的條件不變,只把參考影片前處理的短邊從 768 改成 448;輸出仍是 768×448。
DiT torch allocated/reserved 11.15 / 12.54 → 8.24 / 10.40 GiB;DiT 序列 80,832 → 52,544 列。
這一節沒有畫面:換角實驗用的參考影片是第三方素材,由它衍生的輸出都不公開。數字照常公開。
數字怎麼量、怎麼讀,以及它們不能說明什麼。
不公開的素材:換角實驗用的第三方參考影片與由它衍生的所有輸出、改名前的介面截圖、含路徑或主機名稱的原始紀錄。
即將開放原始碼與架構說明表格與圖表裡的標籤是什麼意思。
定義取自 Phasyn Studio 程式庫(元件目錄與 runtime 說明,commit c5d9310;原始碼尚未公開)與兩個 LoRA 的模型卡。
2026-10-19 從機器上讀取;本頁的 run 是 2026-10-17 與 2026-10-18 跑的。讀不到的項目標「未記錄」。
每個實驗的問題、做法、結論與注意事項。數字都在上面的速度表裡。
同一份文字條件、同一組參考 latent、同一個 seed(42),只換 DiT 變體:FP8/INT8/BF16/NF4 × 原版 50 步/PAI 8/Turbo 8/Turbo 4,加上 attention 與 AdaLN 設定,涵蓋純文字(t2va)與兩張角色圖(ref2va),768×448、124 幀。載入成功的 DiT 都在 RTX 5080 以逐層串流執行。測了 40 個 DiT 變體;37 個成片,3 個 NF4 變體載入失敗。文字條件由 DGX Spark 的 te-gb10 算一次、所有變體共用。
ref2va-pc:文字編碼在 DGX Spark 的 te-gb10,參考影片編碼在 RTX 5080(R3/R6 系列在 RTX 3060),參考聲音編碼與聲音解碼在 RTX 3060,DiT 與影片解碼在 RTX 5080。比較 prompt 寫法、透明與白底角色圖、PAI 8 與 Turbo 4(seed 42、768×448、124 幀)。
vae-5080(影片解碼)與 venc-5080(參考影片編碼)的權重放在 pinned 主記憶體,每次呼叫才搬上 GPU。比較三種配置:兩個都常駐、只停 venc、兩個都停,量冷啟動、第一次與暖呼叫、DiT 速度與可用記憶體。
為 Turbo 4(INT8、lx4 LoRA)建立 465 MB 的 AdaLN 預先計算檔,不必每次線上計算;在 R2、R5 的條件下量 VRAM 與 DiT 時間,並與線上版逐值比對 latent。
在兩個 VAE 常駐的正式配置下跑完整 ref2va-pc(seed 42),測 PAI 8 與 Turbo 4 fixed 的 3 角色 · 124 幀與 2 角色 · 141 幀。第 3 張角色圖是第 2 張的重複,只測記憶體與時間。
R5 條件(PAI 8、2 角色、124 幀、seed 42)只把參考影片前處理的短邊從 768 改成 448(1280×720 → 800×448),輸出仍是 768×448。同時確認 768 對照組與 R5 逐位元相同,以及 Studio 介面與 MCP 的結果相同。
參考影片 448、PAI 8、seed 42,在兩個 VAE 常駐的正式配置下測 2 角色 124/141/158 幀與 3 角色 124 幀,並用 5 個成功點擬合 VRAM 模型。第 3 張角色圖是重複圖。
R5 條件(參考影片 768、2 角色、124 幀),seed 42/7/1234/31337,比較 PAI 8 與 Turbo 4 fixed。seed 42 是完整 pipeline,其餘沿用 R5 的條件編碼,只重跑 DiT 與解碼。
逐條對照外部分析與程式碼、run 紀錄與 payload:拆解 R1 的 DiT 序列組成,用 8 個 run 擬合每步時間與序列長度的關係,並列出 2026-10-17 的 E1–E4 基準 run。
用實際安裝的 MCP 與 Studio 介面準備並執行實驗 06 的 448 實驗,記錄遇到的所有問題,並比對兩條路徑的輸出。
把圖片反推(qimg-vision-gb10,Qwen3-VL-4B BF16)放到 DGX Spark 與 te-gb10 共存;修正部署後實測記憶體、載入與呼叫時間,並修正 te-gb10 跑 ref2va 時重複載入文字編碼器的問題。
第一次 GPU 驗證:30 個 run(28 個經 API、2 個經 Image Studio)。逐像素比對 8 個歷史案例,量 BF16 phase、BF16 stream 與 Qwen-Image GGUF Q4_K_M 三種 DiT 變體的時間與 VRAM、VAE 的 full 與 tiled 解碼,以及中間預覽的代價。GPU 步驟都在 RTX 5080,合成在 CPU。
修正「每次呼叫後釋放 CUDA 快取、失敗時先清 frame」後,在 RTX 5080 正式狀態(H3 的 vae-5080/venc-5080 常駐)重跑實驗 12 失敗的 t2i-pc:同一個 prompt(陶杯)、1024²、40 步、seed 42、VAE full,比較預覽關閉與每 4 步預覽。